
En algún momento de mayo de 2026, internet cruzó una línea: el tráfico automatizado superó al tráfico humano. Cloudflare, que gestiona alrededor de una quinta parte de la web, lo había previsto para la segunda mitad de 2027. Los rastreadores y agentes de IA lo adelantaron más de un año. A principios de junio, el CEO de Cloudflare indicó que los bots realizaban cerca del 57% de las solicitudes de páginas web.
Para los propietarios de sitios web, esto no es solo una estadística. Cada solicitud de un bot consume la misma CPU, memoria y ancho de banda que un visitante real, y en muchos sitios una parte cada vez mayor de esa carga procede de rastreadores de IA que no envían prácticamente a nadie de vuelta. Esta guía te muestra cómo ver qué parte de tu tráfico son bots, cuáles permitir y cómo controlar el resto.
Puntos clave
- Según Cloudflare, el tráfico automatizado superó al tráfico humano en mayo de 2026.
- En junio de 2026, el entrenamiento de IA representaba el 52% de las solicitudes de rastreadores, y la mayoría de los rastreadores de entrenamiento apenas devuelven tráfico.
- Las solicitudes de bots consumen CPU, memoria y ancho de banda reales, y pueden provocar errores 503 en el hosting compartido.
- Bloquea los bots de entrenamiento en robots.txt sin bloquear los de búsqueda, y aplica límites en el servidor a los bots que lo ignoran.
- La caché de página completa abarata los rastreos repetidos, ya que la mayor parte de lo que obtienen los bots no ha cambiado.
¿Qué magnitud tiene el cambio?
Las propias cifras de Cloudflare de 2026 muestran lo rápido que ha ocurrido:
- Las solicitudes diarias de agentes de IA crecieron más de un 1.700% en un año.
- En junio de 2026, el entrenamiento de IA representaba el 52% de las solicitudes de rastreadores, frente al 22% de la primavera de 2025.
- Más de la mitad de lo que obtienen los bots que se comportan correctamente no ha cambiado desde su última visita.
- En algunas categorías muy rastreadas, el tráfico humano cayó hasta un 40% en menos de un año, porque la gente obtiene respuestas de herramientas de IA en lugar de hacer clic.
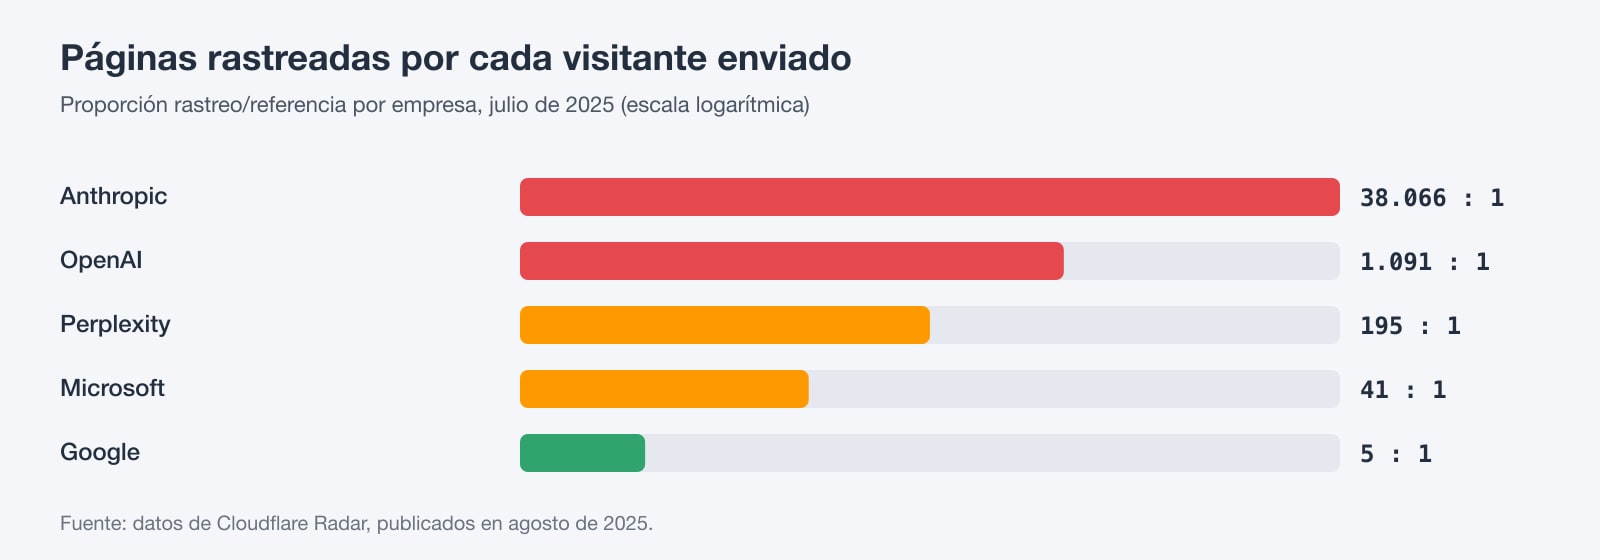
El desequilibrio se ve con más claridad en lo que Cloudflare llama la proporción entre rastreo y referencias: cuántas páginas rastrean los bots de una empresa por cada visitante que sus productos envían de vuelta. En julio de 2025, Google rastreó unas 5 páginas por visitante referido. OpenAI rastreó unas 1.091. Anthropic rastreó unas 38.066. Los buscadores rastrean para enviarte tráfico; la mayoría de los rastreadores de entrenamiento de IA, no.
Lo que les cuesta a los propietarios de sitios
Algunos de los ejemplos más claros proceden de organizaciones que publicaron sus cifras:
- Read the Docs informó de que un solo rastreador descargó 73 TB de archivos en mayo de 2024, casi 10 TB en un solo día, con un coste de más de 5.000 $ en ancho de banda. Bloquear los rastreadores de IA redujo su ancho de banda de descarga diario en un 75%.
- Wikimedia descubrió que los bots generaban alrededor del 35% de las páginas vistas, pero al menos el 65% de su tráfico más exigente en recursos, porque los rastreadores solicitan páginas que no están en caché.
- El fundador de SourceHut contó que llegó a dedicar hasta toda su semana laboral a combatir rastreadores que ignoraban robots.txt, con decenas de caídas breves por semana.
En un sitio más pequeño, el coste se manifiesta de otra forma. En el hosting compartido, cada solicitud cuenta para los límites de recursos de tu cuenta. Una ráfaga de solicitudes de rastreadores a páginas sin caché puede agotar tus workers de PHP y provocar errores 503 o lentitud para los visitantes reales, los mismos síntomas que explicamos en nuestra guía sobre límites LVE y errores 503. En un VPS o servidor cloud, se nota en picos de CPU y en el consumo de ancho de banda.
Paso 1: Averigua qué parte de tu tráfico son bots
El registro de acceso de tu servidor web guarda el user agent de cada solicitud. Estos comandos cuentan las solicitudes y el ancho de banda por bot:
# Requests per AI and search bot
awk -F'"' '{print $6}' access.log \
  | grep -oiE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|Googlebot|Bingbot|Applebot|meta-externalagent|Bytespider|CCBot|Amazonbot' \
  | sort | uniq -c | sort -rn

# Bandwidth per AI crawler
awk -F'"' '{split($3,a," "); ua=$6;
  if (match(ua,/GPTBot|ClaudeBot|Bytespider|CCBot|Amazonbot|meta-externalagent/))
    b[substr(ua,RSTART,RLENGTH)]+=a[2]}
  END {for (k in b) printf "%-20s %.1f MB\n", k, b[k]/1048576}' access.log

# The 20 busiest user agents overall
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20
En el hosting con cPanel, tus registros de acceso sin procesar están en Metrics > Raw Access, o en ~/access-logs/ por SSH. En un VPS suelen estar en /var/log/nginx/ o /var/log/apache2/.
Paso 2: Debes saber qué bots permitir
La mayoría de las empresas de IA usan bots distintos para el entrenamiento, para la búsqueda y para obtener páginas cuando un usuario lo pide. Bloquear el equivocado puede sacarte de las búsquedas con IA, así que conviene conocer la diferencia:
- Rastreadores de entrenamiento: GPTBot (OpenAI), ClaudeBot (Anthropic), meta-externalagent (Meta), CCBot (Common Crawl), Amazonbot (Amazon) y Bytespider (ByteDance). Bloquearlos no afecta a tu visibilidad en las búsquedas.
- Rastreadores de búsqueda con IA: OAI-SearchBot (búsqueda de ChatGPT), Claude-SearchBot y PerplexityBot. Si los bloqueas, desapareces de los resultados de esas búsquedas con IA.
- Agentes activados por el usuario: ChatGPT-User, Claude-User y Perplexity-User obtienen una página porque alguien ha preguntado por ella. OpenAI y Perplexity afirman que pueden no respetar robots.txt, porque la solicitud la inició una persona.
- Tokens de control, no rastreadores: Google-Extended y Applebot-Extended no rastrean nada. Indican a Google y Apple si el contenido que obtuvieron sus rastreadores habituales puede usarse para entrenar IA. Bloquearlos no afecta a la Búsqueda de Google ni a las funciones de búsqueda de Apple.
Paso 3: Define tus reglas en robots.txt
Para la mayoría de las empresas, una configuración razonable por defecto es seguir visibles en los buscadores y en las búsquedas con IA, pero excluirse del entrenamiento:
# Opt out of AI model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: CCBot
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /

# Stay in AI search
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

# Everyone else, including Googlebot and Bingbot
User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
Anthropic, Common Crawl y Bing también respetan una línea Crawl-delay, como Crawl-delay: 5, para ralentizar el rastreo en lugar de bloquearlo. Google y Amazon la ignoran.
robots.txt es una petición, no un candado Los rastreadores bien configurados de OpenAI, Anthropic, Google y otros respetan robots.txt, pero nada obliga a un bot a hacerlo. Los agentes activados por el usuario pueden saltárselo, se ha informado ampliamente de que Bytespider lo ignora y, en 2025, Cloudflare denunció que Perplexity rastreaba con user agents no declarados que imitaban navegadores (Perplexity lo negó). Para los bots que no se comportan, aplica límites en el servidor.
Paso 4: Aplica límites en el servidor
Hosting con Apache, LiteSpeed y cPanel (.htaccess)
En Apache y LiteSpeed, incluido el hosting cPanel y WordPress de WebGee, puedes rechazar bots concretos en .htaccess:
# .htaccess: refuse crawlers you don't want, with a 403
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (Bytespider|CCBot|meta-externalagent) [NC]
RewriteRule .* - [F,L]
nginx: limita la frecuencia de los rastreadores de IA en lugar de bloquearlos
En tu propio VPS, nginx puede ralentizar a los rastreadores de IA sin afectar a las personas ni a los buscadores. Las solicitudes de otros user agents reciben una clave vacía y nunca se limitan:
# http {} block
map $http_user_agent $ai_bot {
    default "";
    ~*(GPTBot|ClaudeBot|CCBot|Bytespider|Amazonbot|meta-externalagent|PerplexityBot) $binary_remote_addr;
}
limit_req_zone $ai_bot zone=aibots:10m rate=30r/m;
limit_req_status 429;

# server {} or location / {}
limit_req zone=aibots burst=10 nodelay;
Comprueba que un "Googlebot" sea realmente Google
Los user agents son fáciles de falsificar, y los scrapers suelen hacerse pasar por Googlebot para saltarse las reglas. Verifícalo con una búsqueda DNS inversa y, después, una búsqueda directa que devuelva la misma IP. OpenAI, Anthropic y Perplexity, en cambio, publican los rangos de IP de sus rastreadores como archivos JSON.
# Reverse lookup: a real Googlebot resolves to googlebot.com or google.com
host 66.249.66.1
# crawl-66-249-66-1.googlebot.com

# Forward lookup must return the same IP
host crawl-66-249-66-1.googlebot.com
# 66.249.66.1
Paso 5: Usa caché para que los bots te cuesten menos
Como más de la mitad de lo que obtienen los bots no ha cambiado desde su última visita, la solución más económica suele ser una caché de página completa. Una página en caché se sirve directamente desde la memoria o el disco, sin ejecutar PHP ni consultar la base de datos, así que una ráfaga de rastreo apenas se nota. En WordPress, el plugin LiteSpeed Cache se encarga de ello en servidores LiteSpeed una vez activado. En otros entornos, usa la caché FastCGI de nginx, Varnish o la caché de una CDN.
Paso 6: Usa los controles de IA de tu CDN
Si tu sitio usa Cloudflare, ahora dispones de controles por finalidad. Desde julio de 2026 puedes permitir o bloquear rastreadores por separado para búsqueda, uso por agentes y entrenamiento, o bloquearlos solo en las páginas con anuncios, en todos los planes, incluido el Free. El 15 de septiembre de 2026, Cloudflare cambió la configuración por defecto para los sitios nuevos, y para los sitios del plan Free que no habían cambiado su configuración: la búsqueda está permitida, pero el entrenamiento y el uso por agentes están bloqueados en las páginas con anuncios. Los rastreadores que mezclan búsqueda y entrenamiento sin dejarte elegir se bloquean en esas páginas.
Si usas Cloudflare, revisa esta configuración ahora. Puede que los nuevos valores por defecto ya estén activos en tu sitio y que prefieras otra opción. Cloudflare también te permite añadir Content Signals, como Content-Signal: search=yes, ai-train=no, a tu robots.txt para declarar tus preferencias.
Lista de control de bots de IA
- Cuenta las solicitudes de bots y el ancho de banda en tus registros de acceso
- Decide: seguir en las búsquedas con IA, excluirte del entrenamiento o ambas cosas
- Actualiza robots.txt con reglas separadas para los bots de entrenamiento y los de búsqueda
- Bloquea o limita en el servidor los bots que ignoran robots.txt
- Verifica todo lo que diga ser Googlebot antes de confiar en ello
- Activa la caché de página completa para que los rastreos repetidos salgan baratos
- Revisa la configuración y los valores por defecto de tu CDN para los rastreadores de IA
Un hosting que evita que los bots te ralenticen
El tráfico de bots ya forma parte normal de la gestión de un sitio web, así que tu hosting debe poder absorberlo. El hosting de WebGee funciona con servidores web LiteSpeed, compatibles con LiteSpeed Cache: una caché de página completa que sirve las solicitudes repetidas sin tocar PHP. Tienes control total sobre .htaccess y robots.txt, acceso a tus registros sin procesar, integración con la CDN de Cloudflare en el hosting cloud con cPanel y soporte 24/7 de ingenieros que pueden ayudarte a interpretar tus registros y detectar un problema con rastreadores.
Si los bots llevan con frecuencia tu sitio al límite de sus recursos, un servidor cloud te ofrece recursos dedicados y control total sobre nginx, los límites de frecuencia y los firewalls.
Preguntas frecuentes
¿Si bloqueo GPTBot, mi sitio desaparecerá de ChatGPT?
No. GPTBot recopila datos para entrenamiento. La búsqueda de ChatGPT usa OAI-SearchBot, así que permite OAI-SearchBot si quieres aparecer en los resultados de búsqueda de ChatGPT.
¿Bloquear Google-Extended afecta a mi posicionamiento en Google?
No. Google-Extended solo controla si tu contenido se usa para el entrenamiento y la fundamentación (grounding) de Gemini. Google afirma que no afecta a la inclusión en la Búsqueda de Google ni al posicionamiento.
¿Todos los bots de IA respetan robots.txt?
No. Los principales rastreadores de entrenamiento y de búsqueda dicen que sí, pero los agentes que obtienen páginas a petición de un usuario pueden no hacerlo, y se ha informado ampliamente de que algunos rastreadores, como Bytespider, lo ignoran. Para esos casos, usa reglas en el servidor o tu CDN.
¿Cómo sé si los bots están ralentizando mi sitio?
Cuenta las solicitudes por user agent en tus registros de acceso y compara los periodos de más actividad con tu uso de recursos. En cPanel, revisa en Resource Usage si se alcanzaron los límites en esos mismos momentos.
¿Qué cambió en Cloudflare el 15 de septiembre de 2026?
Para los sitios nuevos, y para los sitios del plan Free que no habían cambiado su configuración, Cloudflare ahora permite los rastreadores de búsqueda, pero bloquea por defecto el entrenamiento de IA y el uso por agentes en las páginas con anuncios.
