
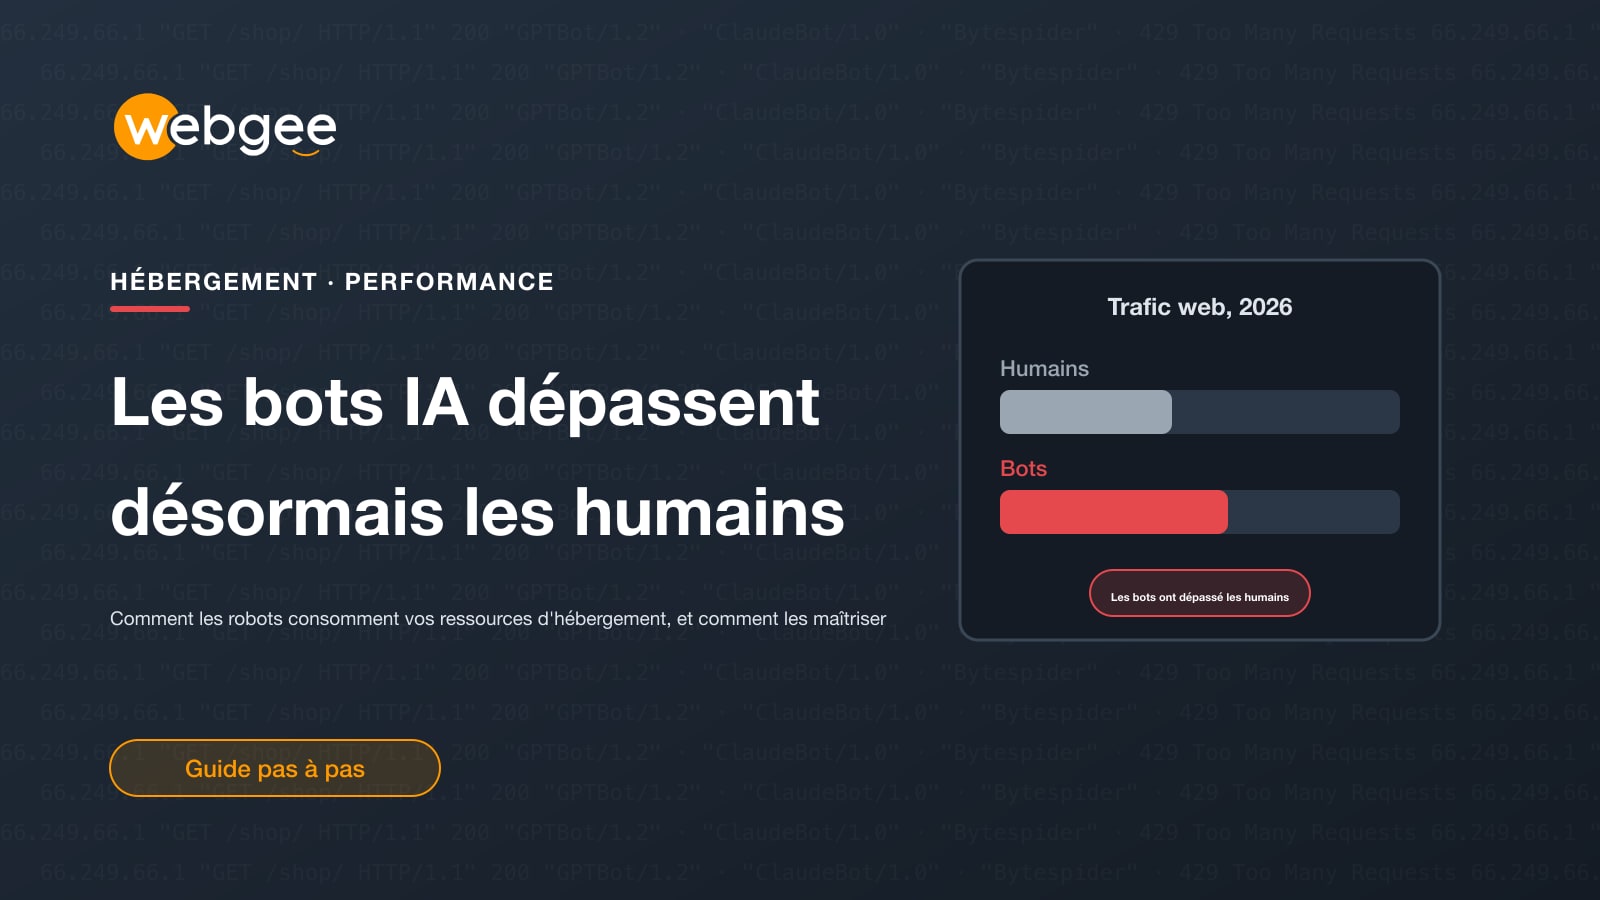
Au cours du mois de mai 2026, Internet a franchi un cap : le trafic automatisé a dépassé le trafic humain. Cloudflare, qui gère environ un cinquième du Web, avait prévu ce basculement pour le second semestre 2027. Les robots d'exploration et les agents d'IA l'ont avancé de plus d'un an. Début juin, le PDG de Cloudflare indiquait que les bots représentaient environ 57 % des requêtes de pages web.
Pour les propriétaires de sites, ce n'est pas qu'une statistique. Chaque requête de bot consomme autant de CPU, de mémoire et de bande passante qu'un vrai visiteur, et sur de nombreux sites, une part croissante de cette charge provient de robots d'exploration d'IA qui ne renvoient quasiment personne. Ce guide vous montre comment mesurer la part des bots dans votre trafic, lesquels autoriser et comment maîtriser les autres.
À retenir
- Selon Cloudflare, le trafic automatisé a dépassé le trafic humain en mai 2026.
- En juin 2026, l'entraînement d'IA représentait 52 % des requêtes des robots d'exploration, et la plupart des robots d'entraînement ne renvoient que très peu de trafic.
- Les requêtes des bots consomment réellement du CPU, de la mémoire et de la bande passante, et peuvent provoquer des erreurs 503 sur un hébergement mutualisé.
- Bloquez les bots d'entraînement dans robots.txt tout en autorisant les bots de recherche, et appliquez des limites côté serveur pour les bots qui l'ignorent.
- La mise en cache de pages complètes rend les explorations répétées peu coûteuses, puisque la plupart des contenus récupérés par les bots n'ont pas changé.
Quelle est l'ampleur du phénomène ?
Les chiffres publiés par Cloudflare en 2026 montrent la rapidité de cette évolution :
- Les requêtes quotidiennes des agents d'IA ont augmenté de plus de 1 700 % en un an.
- En juin 2026, l'entraînement d'IA représentait 52 % des requêtes des robots d'exploration, contre 22 % au printemps 2025.
- Plus de la moitié des contenus récupérés par les bots respectueux des règles n'ont pas changé depuis leur dernier passage.
- Dans certaines catégories très explorées, le trafic humain a chuté jusqu'à 40 % en moins d'un an, les internautes obtenant leurs réponses auprès d'outils d'IA au lieu de cliquer sur les liens.
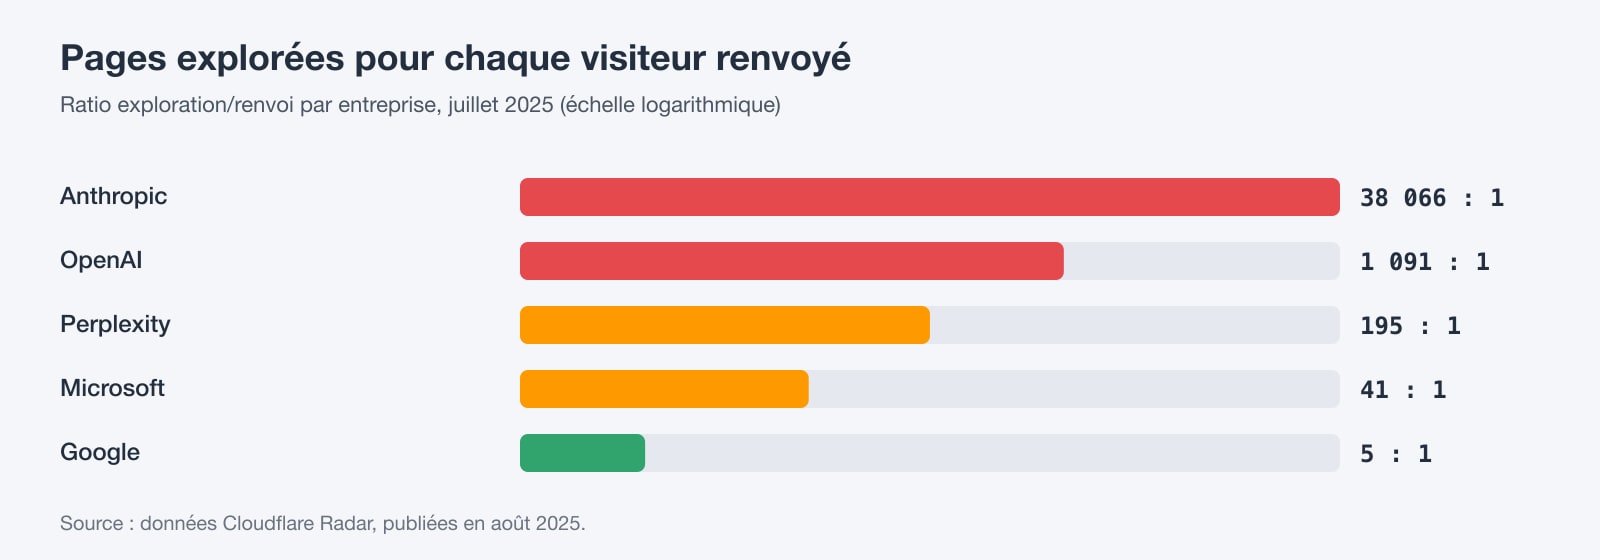
Le déséquilibre apparaît clairement dans ce que Cloudflare appelle le ratio exploration/renvoi : le nombre de pages explorées par les bots d'une entreprise pour chaque visiteur que ses produits renvoient. En juillet 2025, Google explorait environ 5 pages par visiteur renvoyé. OpenAI en explorait environ 1 091. Anthropic, environ 38 066. Les moteurs de recherche explorent pour vous envoyer du trafic ; la plupart des robots d'entraînement d'IA, non.
Ce que cela coûte aux propriétaires de sites
Certains des exemples les plus parlants proviennent d'organisations qui ont publié leurs chiffres :
- Read the Docs a indiqué qu'un seul robot avait téléchargé 73 TB de fichiers en mai 2024, dont près de 10 TB en une seule journée, pour un coût de bande passante de plus de 5 000 $. Le blocage des robots d'IA a réduit de 75 % sa bande passante de téléchargement quotidienne.
- Wikimedia a constaté que les bots représentaient environ 35 % des pages vues, mais au moins 65 % de son trafic le plus gourmand en ressources, car les robots demandent des pages qui ne sont pas en cache.
- Le fondateur de SourceHut a expliqué passer jusqu'à la totalité de sa semaine de travail à lutter contre des robots qui ignoraient robots.txt, avec des dizaines de courtes interruptions de service par semaine.
Sur un site plus modeste, le coût se manifeste autrement. Sur un hébergement mutualisé, chaque requête est décomptée des limites de ressources de votre compte. Une rafale de requêtes de robots vers des pages non mises en cache peut épuiser vos workers PHP et provoquer des erreurs 503 ou des ralentissements pour vos vrais visiteurs, les mêmes symptômes que ceux décrits dans notre guide sur les limites LVE et les erreurs 503. Sur un VPS ou un serveur cloud, cela se traduit par des pics de CPU et une consommation de bande passante.
Étape 1 : mesurez la part des bots dans votre trafic
Le log d'accès de votre serveur web enregistre le user agent de chaque requête. Ces commandes comptent les requêtes et la bande passante par bot :
# Requests per AI and search bot
awk -F'"' '{print $6}' access.log \
  | grep -oiE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|Googlebot|Bingbot|Applebot|meta-externalagent|Bytespider|CCBot|Amazonbot' \
  | sort | uniq -c | sort -rn

# Bandwidth per AI crawler
awk -F'"' '{split($3,a," "); ua=$6;
  if (match(ua,/GPTBot|ClaudeBot|Bytespider|CCBot|Amazonbot|meta-externalagent/))
    b[substr(ua,RSTART,RLENGTH)]+=a[2]}
  END {for (k in b) printf "%-20s %.1f MB\n", k, b[k]/1048576}' access.log

# The 20 busiest user agents overall
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20
Sur un hébergement cPanel, vos logs d'accès bruts se trouvent dans Metrics > Raw Access, ou dans ~/access-logs/ via SSH. Sur un VPS, ils se trouvent généralement dans /var/log/nginx/ ou /var/log/apache2/.
Étape 2 : identifiez les bots à autoriser
La plupart des entreprises d'IA utilisent des bots distincts pour l'entraînement, pour la recherche et pour récupérer des pages à la demande d'un utilisateur. Bloquer le mauvais peut vous faire disparaître de la recherche IA : mieux vaut donc connaître la différence.
- Robots d'entraînement : GPTBot (OpenAI), ClaudeBot (Anthropic), meta-externalagent (Meta), CCBot (Common Crawl), Amazonbot (Amazon) et Bytespider (ByteDance). Les bloquer n'a aucun effet sur votre visibilité dans les moteurs de recherche.
- Robots de recherche IA : OAI-SearchBot (recherche ChatGPT), Claude-SearchBot et PerplexityBot. Si vous les bloquez, vous disparaissez des résultats de ces recherches IA.
- Récupérateurs déclenchés par l'utilisateur : ChatGPT-User, Claude-User et Perplexity-User récupèrent une page parce que quelqu'un a posé une question à son sujet. OpenAI et Perplexity indiquent qu'ils peuvent ne pas suivre robots.txt, puisque la requête est initiée par une personne.
- Des jetons de contrôle, pas des robots : Google-Extended et Applebot-Extended n'explorent rien du tout. Ils indiquent à Google et Apple si le contenu récupéré par leurs robots habituels peut servir à l'entraînement d'IA. Les bloquer n'a aucun effet sur la recherche Google ni sur les fonctionnalités de recherche d'Apple.
Étape 3 : définissez vos règles dans robots.txt
Pour la plupart des entreprises, un choix par défaut judicieux consiste à rester visible dans la recherche classique et la recherche IA tout en refusant l'entraînement :
# Opt out of AI model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: CCBot
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /

# Stay in AI search
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

# Everyone else, including Googlebot and Bingbot
User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
Anthropic, Common Crawl et Bing respectent également une ligne Crawl-delay, par exemple Crawl-delay: 5, pour ralentir l'exploration plutôt que la bloquer. Google et Amazon l'ignorent.
robots.txt est une demande, pas un verrou Les robots respectueux d'OpenAI, d'Anthropic, de Google et d'autres suivent robots.txt, mais rien n'y oblige un bot. Les récupérateurs déclenchés par l'utilisateur peuvent l'ignorer, Bytespider est largement réputé ne pas en tenir compte, et en 2025, Cloudflare a signalé que Perplexity explorait des sites avec des user agents non déclarés, semblables à ceux de navigateurs (ce que Perplexity a contesté). Pour les bots qui ne respectent pas les règles, appliquez des limites côté serveur.
Étape 4 : appliquez des limites côté serveur
Hébergement Apache, LiteSpeed et cPanel (.htaccess)
Sur Apache et LiteSpeed, y compris sur les hébergements cPanel et WordPress de WebGee, vous pouvez refuser des bots spécifiques dans .htaccess :
# .htaccess: refuse crawlers you don't want, with a 403
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (Bytespider|CCBot|meta-externalagent) [NC]
RewriteRule .* - [F,L]
nginx : limiter le débit des robots d'IA plutôt que les bloquer
Sur votre propre VPS, nginx peut ralentir les robots d'IA sans toucher aux visiteurs ni aux moteurs de recherche. Les requêtes provenant d'autres user agents reçoivent une clé vide et ne sont jamais limitées :
# http {} block
map $http_user_agent $ai_bot {
    default "";
    ~*(GPTBot|ClaudeBot|CCBot|Bytespider|Amazonbot|meta-externalagent|PerplexityBot) $binary_remote_addr;
}
limit_req_zone $ai_bot zone=aibots:10m rate=30r/m;
limit_req_status 429;

# server {} or location / {}
limit_req zone=aibots burst=10 nodelay;
Vérifiez qu'un « Googlebot » est bien Google
Les user agents sont faciles à usurper, et les scrapers se font souvent passer pour Googlebot afin de contourner les règles. Vérifiez-le à l'aide d'une recherche DNS inverse, puis d'une recherche directe qui doit renvoyer la même adresse IP. OpenAI, Anthropic et Perplexity, eux, publient les plages d'adresses IP de leurs robots sous forme de fichiers JSON.
# Reverse lookup: a real Googlebot resolves to googlebot.com or google.com
host 66.249.66.1
# crawl-66-249-66-1.googlebot.com

# Forward lookup must return the same IP
host crawl-66-249-66-1.googlebot.com
# 66.249.66.1
Étape 5 : mettez en cache pour que les bots vous coûtent moins cher
Comme plus de la moitié des contenus récupérés par les bots n'ont pas changé depuis leur dernier passage, la solution la plus économique est souvent un cache de pages complètes. Une page en cache est servie directement depuis la mémoire ou le disque, sans exécuter PHP ni interroger la base de données : une rafale de robots passe ainsi presque inaperçue. Sous WordPress, le plugin LiteSpeed Cache s'en charge sur les serveurs LiteSpeed une fois activé. Sur d'autres environnements, utilisez le cache FastCGI de nginx, Varnish ou le cache d'un CDN.
Étape 6 : utilisez les contrôles d'IA de votre CDN
Si votre site utilise Cloudflare, vous disposez désormais de contrôles par usage. Depuis juillet 2026, vous pouvez autoriser ou bloquer les robots séparément pour la recherche, l'utilisation par des agents et l'entraînement, ou les bloquer uniquement sur les pages contenant des publicités, et ce sur toutes les offres, y compris Free. Le 15 septembre 2026, Cloudflare a modifié les paramètres par défaut pour les nouveaux sites, ainsi que pour les sites du plan Free dont les paramètres n'avaient pas été modifiés : la recherche est autorisée, mais l'entraînement et l'utilisation par des agents sont bloqués sur les pages contenant des publicités. Les robots qui mélangent recherche et entraînement sans vous laisser le choix sont bloqués sur ces pages.
Si vous utilisez Cloudflare, vérifiez ces paramètres dès maintenant. Les nouveaux paramètres par défaut sont peut-être déjà actifs sur votre site, et vous pourriez préférer un autre choix. Cloudflare vous permet également d'ajouter des Content Signals, comme Content-Signal: search=yes, ai-train=no, à votre robots.txt pour exprimer vos préférences.
Checklist de contrôle des bots d'IA
- Comptez les requêtes et la bande passante des bots dans vos logs d'accès
- Décidez : rester dans la recherche IA, refuser l'entraînement, ou les deux
- Mettez à jour robots.txt avec des règles distinctes pour les bots d'entraînement et de recherche
- Bloquez ou limitez côté serveur les bots qui ignorent robots.txt
- Vérifiez tout ce qui prétend être Googlebot avant de lui faire confiance
- Activez la mise en cache de pages complètes pour que les explorations répétées soient peu coûteuses
- Passez en revue les paramètres et les valeurs par défaut de votre CDN concernant les robots d'IA
Un hébergement qui empêche les bots de vous ralentir
Le trafic des bots fait désormais partie intégrante de la gestion d'un site web : votre hébergement doit donc pouvoir l'absorber. L'hébergement WebGee repose sur des serveurs web LiteSpeed, compatibles avec LiteSpeed Cache, un cache de pages complètes qui sert les requêtes répétées sans solliciter PHP. Vous bénéficiez d'un contrôle total sur .htaccess et robots.txt, d'un accès à vos logs bruts, de l'intégration du CDN Cloudflare sur l'hébergement cloud cPanel et d'un support 24/7 assuré par des ingénieurs qui peuvent vous aider à analyser vos logs et à repérer un problème de robots d'exploration.
Si des bots poussent régulièrement votre site jusqu'à ses limites de ressources, un serveur cloud vous offre des ressources dédiées et un contrôle total sur nginx, les limites de débit et les pare-feu.
Questions fréquentes
Bloquer GPTBot va-t-il retirer mon site de ChatGPT ?
Non. GPTBot collecte des données d'entraînement. La recherche ChatGPT utilise OAI-SearchBot : autorisez donc OAI-SearchBot si vous souhaitez apparaître dans les résultats de recherche de ChatGPT.
Bloquer Google-Extended a-t-il un impact sur mon classement dans Google ?
Non. Google-Extended détermine uniquement si votre contenu peut servir à l'entraînement et à l'ancrage (grounding) de Gemini. Google affirme que cela n'a aucune incidence sur l'inclusion dans la recherche Google ni sur le classement.
Tous les bots d'IA respectent-ils robots.txt ?
Non. Les principaux robots d'entraînement et de recherche affirment le respecter, mais les récupérateurs déclenchés par les utilisateurs peuvent ne pas le faire, et certains robots comme Bytespider sont largement réputés l'ignorer. Pour ceux-là, utilisez des règles serveur ou votre CDN.
Comment savoir si des bots ralentissent mon site ?
Comptez les requêtes par user agent dans vos logs d'accès et comparez les périodes de forte activité avec votre consommation de ressources. Sous cPanel, consultez Resource Usage pour repérer les dépassements de limites aux mêmes moments.
Qu'est-ce qui a changé chez Cloudflare le 15 septembre 2026 ?
Pour les nouveaux sites, ainsi que pour les sites du plan Free dont les paramètres n'avaient pas été modifiés, Cloudflare autorise désormais par défaut les robots de recherche, mais bloque l'entraînement d'IA et l'utilisation par des agents sur les pages contenant des publicités.
