
Depuis un an, llms.txt est présenté comme la solution miracle pour la recherche IA : ajoutez un simple fichier texte à votre site, et ChatGPT, Gemini et Perplexity vous comprendront mieux. Des milliers de sites en ont ajouté un, et les outils SEO signalent désormais ceux qui n'en ont pas.
Les données de 2026 racontent une tout autre histoire. Ce guide explique ce qu'est llms.txt, ce que révèlent les faits sur qui le lit réellement, dans quels cas il est vraiment utile, et ce qui détermine réellement si les outils de recherche IA peuvent trouver et citer votre site.
À retenir
- llms.txt est un fichier Markdown, proposé en septembre 2024, qui fournit aux outils d'IA une carte sélective de votre site.
- Google indique que son moteur de recherche ignore llms.txt, et 97 % des fichiers n'ont reçu aucune requête en mai 2026 (Ahrefs).
- Il aide en revanche les assistants de code IA à lire la documentation pour développeurs.
- La visibilité dans la recherche IA dépend de l'autorisation des bons robots, d'un contenu présent dans le HTML et de bases SEO solides.
- Bloquer des robots d'entraînement comme GPTBot ne vous retire pas de la recherche ChatGPT ; bloquer OAI-SearchBot, si.
La réponse courte llms.txt ne vous aide ni à vous classer ni à être cité dans la recherche IA. Google indique que son moteur de recherche l'ignore, et les données de logs montrent que les robots de recherche IA ne le récupèrent presque jamais. Il est utile pour un public précis : les assistants de code IA qui lisent de la documentation pour développeurs. Si vous publiez une documentation ou une API, ajoutez-en un. Sinon, consacrez plutôt votre temps aux fondamentaux présentés ci-dessous.
Qu'est-ce que llms.txt ?
llms.txt a été proposé par Jeremy Howard, d'Answer.AI, en septembre 2024. Il s'agit d'un fichier Markdown placé à l'adresse /llms.txt qui fournit aux outils d'IA une carte courte et sélective de votre site : ce qu'il est, et des liens vers les pages les plus importantes, idéalement en Markdown propre plutôt qu'en HTML encombré de menus et de scripts.
Le format est simple. Seul le titre H1 est obligatoire :
- un H1 avec le nom du site ou du projet ;
- un bloc de citation avec un résumé d'une ligne ;
- des paragraphes facultatifs apportant du contexte supplémentaire ;
- des sections H2 contenant des listes de liens, chacun pouvant être suivi d'une courte note ;
- par convention, une section Optional pour les liens qu'un outil d'IA peut ignorer lorsqu'il manque de place.
# Example Hosting

> Example Hosting provides managed WordPress and VPS hosting with data centres in the EU and US.

Support is available 24/7. Prices are listed in USD.

## Docs

- [Getting started](https://example.com/docs/start.md): Set up your first site
- [DNS guide](https://example.com/docs/dns.md): Point a domain to your hosting

## Optional

- [Changelog](https://example.com/changelog.md)
La version 2 de la spécification, publiée en août 2026, a apporté quelques nouveautés : les copies Markdown des pages peuvent se trouver à page.md aussi bien qu'à page.html.md, les fichiers peuvent couvrir un sous-dossier comme /docs/llms.txt, et les pages peuvent indiquer leur version Markdown ainsi que le llms.txt qui les couvre grâce à des balises ou en-têtes Link standard. Une idée reçue répandue est fausse : llms-full.txt, un fichier unique regroupant toute votre documentation, ne fait pas partie de la spécification. Il s'agit d'une convention introduite par des plateformes de documentation comme Mintlify.
Qui l'a adopté ?
L'adoption a progressé rapidement. Originality.ai a recensé 4 088 fichiers llms.txt en juin 2025 et 36 120 en mai 2026, soit une hausse de 8,8 fois, sur plus de trois millions de sites suivis. Cela ne représente pourtant qu'environ 1 % d'entre eux. Ahrefs a constaté que 28 % des 137 000 domaines utilisant son outil d'analyse en publient un, mais il s'agit surtout de sites très orientés SEO.
Yoast SEO, AIOSEO, Wix, Mintlify et GitBook peuvent tous générer le fichier pour vous, et Lighthouse, l'outil de Chrome, a ajouté une vérification llms.txt à sa nouvelle catégorie « Agentic Browsing » en mai 2026. Cette vérification ne signale qu'un fichier qui renvoie une erreur ; un fichier absent est considéré comme « non applicable ». Les entreprises d'IA publient elles aussi des fichiers llms.txt, mais uniquement pour leur documentation destinée aux développeurs.
Les moteurs de recherche IA le lisent-ils vraiment ?
C'est là que l'engouement s'effondre.
Google : « la recherche Google les ignore »
Le guide 2026 de Google sur l'optimisation pour ses fonctionnalités d'IA générative classe llms.txt parmi les éléments que vous pouvez ignorer. Il précise que vous n'avez besoin d'aucun nouveau fichier lisible par les machines, fichier texte pour l'IA ou contenu Markdown pour apparaître dans la recherche Google ou ses fonctionnalités d'IA, « car la recherche Google elle-même ne les utilise pas ». Une mise à jour de juin 2026 ajoute qu'en créer un pour d'autres services ne pose aucun problème, mais qu'il « ne nuira ni n'aidera » à votre visibilité dans la recherche Google. John Mueller, de Google, l'a comparé à l'ancienne balise meta keywords.
OpenAI, Anthropic et Perplexity : silence radio
Aucune documentation sur les robots d'exploration d'OpenAI, d'Anthropic ou de Perplexity ne mentionne llms.txt. Ces entreprises ne l'ont pas exclu, mais aucune grande plateforme d'IA ne s'est engagée à le lire.
Les logs : 97 % des fichiers n'ont reçu aucune requête
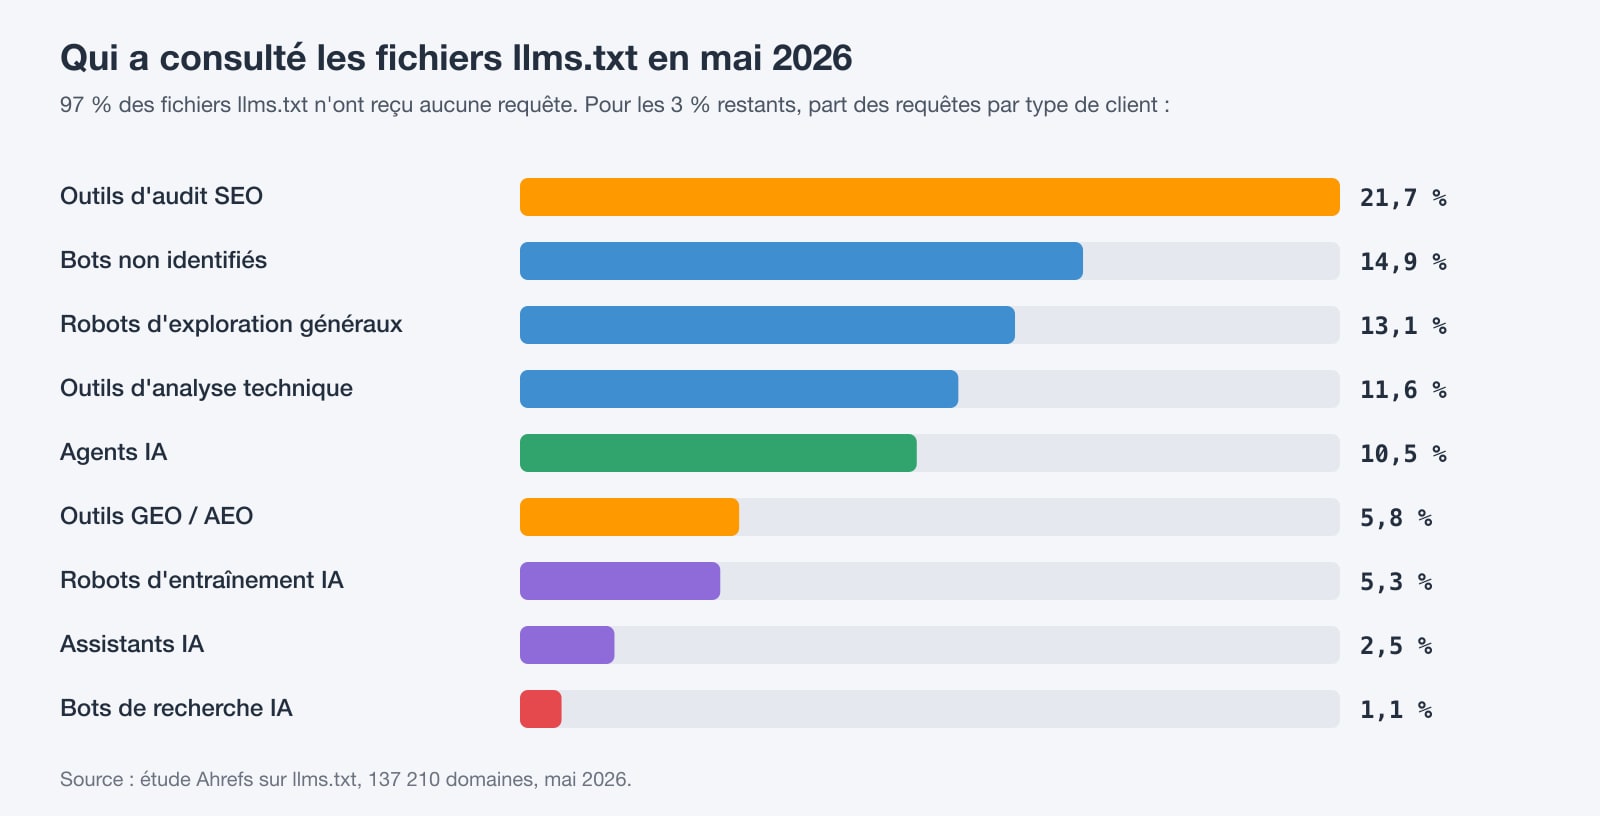
La preuve la plus claire vient d'Ahrefs, qui a analysé les requêtes vers llms.txt sur 137 210 domaines en mai 2026. Sa conclusion : 97 % des fichiers llms.txt n'ont reçu aucun trafic ce mois-là. Absolument rien ne les a récupérés.
Parmi les 3 % qui ont été récupérés, la plupart des requêtes provenaient d'outils d'audit SEO, de robots d'exploration généralistes et d'outils de profilage de sites. Les robots de recherche et de récupération IA comme OAI-SearchBot et PerplexityBot ne représentaient que 1,1 % des requêtes, soit quelques centaines de récupérations au total. Et les robots d'IA n'ont jamais demandé llms.txt sur les sites qui n'en ont pas : ils ne le cherchent pas.
Vérifiez vos propres logs
Inutile de croire qui que ce soit sur parole. Si votre site dispose d'un llms.txt, voici comment voir qui l'a demandé :
# Who fetched llms.txt, by user agent (nginx/Apache combined log format)
grep -h '"GET /llms' /var/log/nginx/access.log* 2>/dev/null \
  | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -20

# cPanel: per-domain logs live under ~/access-logs/
zgrep -h '"GET /llms' ~/access-logs/* | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn
Là où llms.txt est utile : les assistants de code IA
Il existe une catégorie d'outils qui l'utilise : les assistants de code IA comme Claude Code et Cursor, ainsi que les outils construits sur leur base. Dans les données d'Ahrefs, les agents IA ont effectué 10,5 % des requêtes vers llms.txt, bien plus que les robots de recherche et d'assistants IA réunis (3,6 %), et Claude Code était l'outil d'IA identifié le plus actif après le robot d'entraînement d'OpenAI. Lorsqu'un développeur dirige l'un de ces outils vers votre documentation, un index propre de pages Markdown lui permet de trouver rapidement la bonne référence d'API, en consommant beaucoup moins de tokens : Cloudflare a mesuré une page à 16 180 tokens en HTML et à 3 150 en Markdown, soit environ 80 % de moins.
La règle est donc simple :
- Vous publiez une documentation pour développeurs, une API ou un logiciel : ajoutez un llms.txt et des versions Markdown de vos pages de documentation. C'est rapide à faire, et cela simplifie la vie des développeurs qui utilisent des outils d'IA.
- Vous gérez un site d'entreprise, une boutique ou un blog : il est sans danger, et si votre extension SEO le génère automatiquement, laissez-le activé. Mais n'attendez aucun changement de votre trafic issu de la recherche IA.
Ce qui vous fait réellement apparaître dans la recherche IA
Selon Google, pour apparaître sous forme de lien dans les AI Overviews ou le mode IA, une page doit simplement être indexée et éligible à un extrait dans la recherche classique. « Il n'y a aucune exigence technique supplémentaire. » Ce qui compte est la même chose que pour un bon SEO, avec quelques détails propres à l'IA.
1. Ne bloquez pas les robots d'IA que vous souhaitez accueillir
Chaque entreprise d'IA exploite plusieurs robots, qui remplissent des rôles différents. Bloquer le robot d'entraînement ne vous retire pas de la recherche IA, mais bloquer le robot de recherche, si :
- OAI-SearchBot détermine si vous apparaissez dans la recherche ChatGPT. GPTBot sert à l'entraînement.
- Claude-SearchBot indexe pour la recherche de Claude ; ClaudeBot sert à l'entraînement ; Claude-User récupère des pages à la demande d'un utilisateur.
- PerplexityBot alimente la recherche Perplexity et n'est pas utilisé pour l'entraînement.
- Google-Extended n'est pas un robot d'exploration. C'est un réglage de robots.txt qui concerne l'entraînement et l'ancrage (grounding) de Gemini, et il n'a aucun effet sur la recherche Google ni sur les AI Overviews. Pour limiter les AI Overviews, utilisez
nosnippetoumax-snippet. - Applebot-Extended détermine uniquement si Apple peut utiliser le contenu pour l'entraînement.
Voici un robots.txt qui vous garde visible dans la recherche IA tout en refusant l'entraînement des modèles :
# Allow AI search and user-requested fetches
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Allow: /

# Opt out of model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
Vérifiez aussi votre pare-feu et votre CDN Google rappelle que l'exploration doit être autorisée dans robots.txt ainsi que par toute infrastructure de CDN ou d'hébergement. Les règles de protection contre les bots d'un CDN ou d'une extension de sécurité peuvent bloquer silencieusement les robots de recherche IA, même lorsque robots.txt les autorise : vérifiez donc également ces réglages.
Vous pouvez aussi exprimer vos préférences plus précisément grâce aux Content Signals de Cloudflare, qui ajoutent à robots.txt une ligne comme Content-Signal: search=yes, ai-input=yes, ai-train=no. L'IETF travaille à un vocabulaire standard pour les préférences d'usage par l'IA, mais il n'en est encore qu'au stade de brouillon.
2. Placez votre contenu dans le HTML
La plupart des robots d'IA n'exécutent pas JavaScript. Une étude menée par Vercel en 2024 a montré qu'aucun des principaux robots d'IA mesurés n'effectuait le rendu JavaScript, à l'exception de ceux de Google et d'Apple. Si vos textes, vos prix ou les détails de vos produits n'apparaissent qu'après l'exécution de scripts, les outils d'IA risquent de voir une page vide. Utilisez le rendu côté serveur, ou un CMS comme WordPress qui génère le contenu en HTML. Vérifiez ce que voit un robot d'exploration :
# Fetch the raw HTML the way a crawler does, then look for your key text
curl -s -A "OAI-SearchBot/1.0" https://example.com/pricing | grep -i "per month"
3. Soignez les fondamentaux
- Des pages claires et précises qui répondent à de vraies questions, avec des intertitres et des listes.
- Des données structurées qui correspondent à ce qui est visible sur la page. Elles ne sont pas obligatoires pour la recherche IA, mais aident à obtenir des résultats enrichis.
- Un sitemap, un bon maillage interne et un site rapide et fiable. Les recommandations de Google incluent la réduction de la latence dans le cadre d'une bonne expérience de page.
- Une véritable expertise et une réputation qui vous vaut d'être cité par d'autres sites.
Notre approche chez WebGee
Nous publions un llms.txt sur webgee.com, car il ne coûte presque rien à maintenir et aide les outils d'IA qui le lisent. Notre robots.txt indique également nos préférences en matière d'IA via les Content Signals. Mais le travail qui compte vraiment, c'est la partie la moins spectaculaire : des pages rendues côté serveur, un hébergement rapide, des données structurées propres et des contenus rédigés par des personnes qui gèrent de l'hébergement au quotidien.
C'est aussi pour cela que notre hébergement est conçu. Les serveurs web LiteSpeed avec mise en cache assurent des pages rapides, aussi bien pour les visiteurs que pour les robots d'exploration, et vous gardez un contrôle total sur votre robots.txt, votre CDN et vos réglages de sécurité, avec un support 24/7 si vous avez besoin d'aide pour analyser vos logs.
Questions fréquentes
llms.txt améliore-t-il mon classement dans Google ou dans les AI Overviews ?
Non. Google affirme que la recherche Google, y compris ses fonctionnalités d'IA, ignore llms.txt, et qu'en avoir un ne favorisera ni ne pénalisera votre visibilité.
ChatGPT lit-il llms.txt ?
OpenAI n'a jamais déclaré utiliser llms.txt, et les données de logs de 2026 montrent que le robot de recherche d'OpenAI ne le demande presque jamais. La recherche ChatGPT s'appuie sur OAI-SearchBot, que vous devez autoriser dans robots.txt pour y apparaître.
llms.txt est-il nuisible ?
Non. Le publier est sans danger, et utile si vous proposez une documentation pour développeurs. Ne comptez simplement pas sur lui pour vous apporter du trafic issu de la recherche IA.
Qu'est-ce que llms-full.txt ?
Un fichier unique qui regroupe toute la documentation d'un site en Markdown. C'est une convention issue de plateformes de documentation comme Mintlify, et non un élément de la spécification llms.txt.
Comment empêcher les modèles d'IA de s'entraîner sur mon contenu tout en restant présent dans la recherche IA ?
Dans robots.txt, interdisez les robots d'entraînement comme GPTBot, ClaudeBot, Google-Extended et Applebot-Extended, et autorisez les robots de recherche comme OAI-SearchBot, Claude-SearchBot et PerplexityBot.
