
Irgendwann im Mai 2026 hat das Internet eine Schwelle überschritten: Automatisierter Traffic hat den menschlichen Traffic überholt. Cloudflare, über das rund ein Fünftel des Webs läuft, hatte dies für die zweite Hälfte des Jahres 2027 vorhergesagt. KI-Crawler und -Agenten haben die Entwicklung um mehr als ein Jahr beschleunigt. Anfang Juni berichtete der CEO von Cloudflare, dass etwa 57 % der Anfragen nach Webseiten von Bots stammten.
Für Website-Betreiber ist das mehr als nur eine Statistik. Jede Bot-Anfrage verbraucht genauso viel CPU-Leistung, Arbeitsspeicher und Bandbreite wie ein echter Besucher, und auf vielen Websites stammt ein wachsender Teil dieser Last von KI-Crawlern, die so gut wie keine Besucher zurückschicken. Dieser Leitfaden zeigt Ihnen, wie Sie erkennen, wie viel Ihres Traffics von Bots stammt, welche Sie zulassen sollten und wie Sie den Rest kontrollieren.
Das Wichtigste
- Laut Cloudflare hat automatisierter Traffic im Mai 2026 den menschlichen Traffic überholt.
- Bis Juni 2026 entfielen 52 % der Crawler-Anfragen auf KI-Training, und die meisten Trainings-Crawler schicken kaum Besucher zurück.
- Bot-Anfragen verbrauchen echte CPU-Leistung, echten Arbeitsspeicher und echte Bandbreite und können auf Shared Hosting 503-Fehler auslösen.
- Blockieren Sie Trainingsbots in der robots.txt, lassen Sie Suchbots zu und setzen Sie Limits auf dem Server für Bots durch, die die Datei ignorieren.
- Full-Page-Caching macht wiederholte Crawls günstig, da sich das meiste, was Bots abrufen, nicht geändert hat.
Wie groß ist der Wandel?
Die eigenen Zahlen von Cloudflare aus dem Jahr 2026 zeigen, wie schnell es ging:
- Die täglichen Anfragen von KI-Agenten sind innerhalb eines Jahres um mehr als 1.700 % gestiegen.
- Bis Juni 2026 entfielen 52 % der Crawler-Anfragen auf KI-Training, gegenüber 22 % im Frühjahr 2025.
- Mehr als die Hälfte dessen, was gut funktionierende Bots abrufen, hat sich seit ihrem letzten Besuch nicht verändert.
- In einigen stark gecrawlten Kategorien ist der menschliche Traffic in weniger als einem Jahr um bis zu 40 % gesunken, weil Menschen ihre Antworten von KI-Tools erhalten, statt sich durchzuklicken.
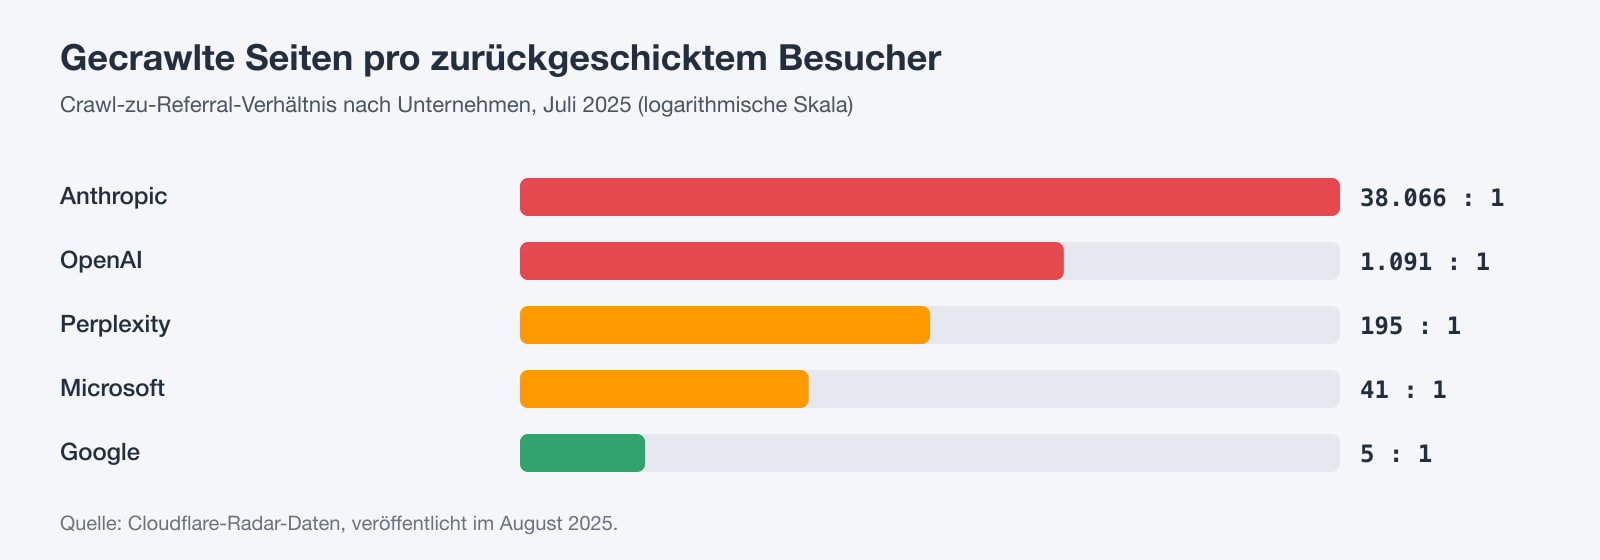
Am deutlichsten wird das Ungleichgewicht bei dem, was Cloudflare das Crawl-to-Referral-Verhältnis nennt: wie viele Seiten die Bots eines Unternehmens für jeden Besucher crawlen, den dessen Produkte zurückschicken. Im Juli 2025 crawlte Google etwa 5 Seiten pro vermitteltem Besucher. OpenAI crawlte etwa 1.091. Anthropic crawlte etwa 38.066. Suchmaschinen crawlen, um Ihnen Traffic zu bringen; die meisten KI-Trainings-Crawler tun das nicht.
Was es Website-Betreiber kostet
Einige der anschaulichsten Beispiele stammen von Organisationen, die ihre Zahlen veröffentlicht haben:
- Read the Docs berichtete, dass ein einzelner Crawler im Mai 2024 73 TB an Dateien heruntergeladen hat, davon fast 10 TB an einem einzigen Tag, was über 5.000 $ an Bandbreitenkosten verursachte. Durch das Blockieren von KI-Crawlern sank die tägliche Download-Bandbreite um 75 %.
- Wikimedia stellte fest, dass Bots zwar etwa 35 % der Seitenaufrufe ausmachten, aber mindestens 65 % des ressourcenintensivsten Traffics, weil Crawler Seiten anfordern, die nicht im Cache liegen.
- Der Gründer von SourceHut beschrieb, dass er bis zu seiner gesamten Arbeitswoche damit verbrachte, Crawler abzuwehren, die die robots.txt ignorierten – bei Dutzenden kurzer Ausfälle pro Woche.
Bei einer kleineren Website machen sich die Kosten anders bemerkbar. Auf Shared Hosting zählt jede Anfrage gegen die Ressourcenlimits Ihres Kontos. Eine Welle von Crawler-Anfragen an nicht gecachte Seiten kann Ihre PHP-Worker auslasten und 503-Fehler oder Verlangsamungen für echte Besucher auslösen – dieselben Symptome, die wir in unserem Leitfaden zu LVE-Limits und 503-Fehlern erklären. Auf einem VPS oder Cloud-Server zeigt es sich in Form von CPU-Spitzen und Bandbreitennutzung.
Schritt 1: Ermitteln Sie, wie viel Ihres Traffics von Bots stammt
Das Access-Log Ihres Webservers erfasst den User-Agent jeder Anfrage. Diese Befehle zählen Anfragen und Bandbreite pro Bot:
# Requests per AI and search bot
awk -F'"' '{print $6}' access.log \
  | grep -oiE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|Googlebot|Bingbot|Applebot|meta-externalagent|Bytespider|CCBot|Amazonbot' \
  | sort | uniq -c | sort -rn

# Bandwidth per AI crawler
awk -F'"' '{split($3,a," "); ua=$6;
  if (match(ua,/GPTBot|ClaudeBot|Bytespider|CCBot|Amazonbot|meta-externalagent/))
    b[substr(ua,RSTART,RLENGTH)]+=a[2]}
  END {for (k in b) printf "%-20s %.1f MB\n", k, b[k]/1048576}' access.log

# The 20 busiest user agents overall
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20
Bei cPanel-Hosting finden Sie Ihre Raw-Access-Logs unter Metrics > Raw Access oder per SSH in ~/access-logs/. Auf einem VPS liegen sie meist in /var/log/nginx/ oder /var/log/apache2/.
Schritt 2: Wissen, welche Bots Sie zulassen sollten
Die meisten KI-Unternehmen betreiben separate Bots für Training, für Suche und für das Abrufen von Seiten auf Anfrage eines Nutzers. Wenn Sie den falschen blockieren, verschwinden Sie möglicherweise aus der KI-Suche – es lohnt sich also, den Unterschied zu kennen:
- Trainings-Crawler: GPTBot (OpenAI), ClaudeBot (Anthropic), meta-externalagent (Meta), CCBot (Common Crawl), Amazonbot (Amazon) und Bytespider (ByteDance). Das Blockieren dieser Bots hat keinen Einfluss auf Ihre Sichtbarkeit in der Suche.
- KI-Such-Crawler: OAI-SearchBot (ChatGPT-Suche), Claude-SearchBot und PerplexityBot. Wenn Sie diese blockieren, verschwinden Sie aus den entsprechenden KI-Suchergebnissen.
- Von Nutzern ausgelöste Abrufe: ChatGPT-User, Claude-User und Perplexity-User rufen eine Seite ab, weil jemand danach gefragt hat. OpenAI und Perplexity geben an, dass diese die robots.txt möglicherweise nicht beachten, da die Anfrage von einer Person ausging.
- Steuerungs-Token statt Crawler: Google-Extended und Applebot-Extended crawlen überhaupt nicht. Sie teilen Google und Apple mit, ob Inhalte, die ihre normalen Crawler abgerufen haben, für KI-Training verwendet werden dürfen. Das Blockieren hat keinen Einfluss auf die Google-Suche oder die Suchfunktionen von Apple.
Schritt 3: Legen Sie Ihre Regeln in der robots.txt fest
Für die meisten Unternehmen ist es sinnvoll, standardmäßig in der Suche und der KI-Suche sichtbar zu bleiben und gleichzeitig dem Training zu widersprechen:
# Opt out of AI model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: CCBot
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /

# Stay in AI search
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

# Everyone else, including Googlebot and Bingbot
User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
Anthropic, Common Crawl und Bing beachten außerdem eine Crawl-delay-Zeile wie Crawl-delay: 5, um das Crawling zu verlangsamen statt es zu blockieren. Google und Amazon ignorieren sie.
Die robots.txt ist eine Bitte, kein Schloss Gut funktionierende Crawler von OpenAI, Anthropic, Google und anderen befolgen die robots.txt, doch nichts zwingt einen Bot dazu. Von Nutzern ausgelöste Abrufe überspringen sie möglicherweise, Bytespider ignoriert sie Berichten zufolge häufig, und 2025 meldete Cloudflare, dass Perplexity mit nicht deklarierten, browserähnlichen User-Agents crawlte (Perplexity bestritt dies). Bei Bots, die sich nicht an die Regeln halten, setzen Sie Limits auf dem Server durch.
Schritt 4: Limits auf dem Server durchsetzen
Apache-, LiteSpeed- und cPanel-Hosting (.htaccess)
Unter Apache und LiteSpeed, auch beim cPanel- und WordPress-Hosting von WebGee, können Sie bestimmte Bots in der .htaccess abweisen:
# .htaccess: refuse crawlers you don't want, with a 403
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (Bytespider|CCBot|meta-externalagent) [NC]
RewriteRule .* - [F,L]
nginx: KI-Crawler drosseln statt blockieren
Auf Ihrem eigenen VPS kann nginx KI-Crawler ausbremsen, während Menschen und Suchmaschinen unberührt bleiben. Anfragen von anderen User-Agents erhalten einen leeren Schlüssel und werden nie begrenzt:
# http {} block
map $http_user_agent $ai_bot {
    default "";
    ~*(GPTBot|ClaudeBot|CCBot|Bytespider|Amazonbot|meta-externalagent|PerplexityBot) $binary_remote_addr;
}
limit_req_zone $ai_bot zone=aibots:10m rate=30r/m;
limit_req_status 429;

# server {} or location / {}
limit_req zone=aibots burst=10 nodelay;
Prüfen Sie, ob ein „Googlebot“ wirklich von Google stammt
User-Agents lassen sich leicht fälschen, und Scraper geben sich häufig als Googlebot aus, um Regeln zu umgehen. Prüfen Sie dies mit einem Reverse-DNS-Lookup und anschließend einem Forward-Lookup, der dieselbe IP zurückliefert. OpenAI, Anthropic und Perplexity veröffentlichen ihre Crawler-IP-Bereiche stattdessen als JSON-Dateien.
# Reverse lookup: a real Googlebot resolves to googlebot.com or google.com
host 66.249.66.1
# crawl-66-249-66-1.googlebot.com

# Forward lookup must return the same IP
host crawl-66-249-66-1.googlebot.com
# 66.249.66.1
Schritt 5: Caching, damit Bots Sie weniger kosten
Da sich mehr als die Hälfte dessen, was Bots abrufen, seit ihrem letzten Besuch nicht verändert hat, ist ein Full-Page-Cache oft die günstigste Lösung. Eine gecachte Seite wird direkt aus dem Arbeitsspeicher oder von der Festplatte ausgeliefert, ohne PHP auszuführen oder die Datenbank abzufragen – eine Crawler-Welle fällt so kaum ins Gewicht. Unter WordPress übernimmt das auf LiteSpeed-Servern das Plugin LiteSpeed Cache, sobald es aktiviert ist. Auf anderen Stacks nutzen Sie den nginx-FastCGI-Cache, Varnish oder einen CDN-Cache.
Schritt 6: Nutzen Sie die KI-Steuerung Ihres CDN
Wenn Ihre Website Cloudflare nutzt, stehen Ihnen jetzt zweckgebundene Einstellungen zur Verfügung. Seit Juli 2026 können Sie Crawler getrennt für Suche, Agent-Nutzung und Training zulassen oder blockieren oder sie nur auf Seiten mit Werbung blockieren – in allen Tarifen, auch im Free-Plan. Am 15. September 2026 hat Cloudflare die Standardeinstellung für neue Websites sowie für Websites im Free-Plan, deren Einstellungen nicht geändert wurden, angepasst: Die Suche ist erlaubt, Training und Agent-Nutzung sind auf Seiten mit Werbung jedoch blockiert. Crawler, die Suche und Training vermischen, ohne Ihnen eine Wahl zu lassen, werden auf diesen Seiten blockiert.
Wenn Sie Cloudflare nutzen, prüfen Sie diese Einstellungen jetzt. Die neuen Standardwerte sind auf Ihrer Website möglicherweise bereits aktiv, und vielleicht bevorzugen Sie eine andere Wahl. Cloudflare ermöglicht es Ihnen außerdem, Content Signals wie Content-Signal: search=yes, ai-train=no in Ihre robots.txt aufzunehmen, um Ihre Präferenzen festzulegen.
Checkliste zur Kontrolle von KI-Bots
- Bot-Anfragen und Bandbreite in Ihren Access-Logs zählen
- Entscheiden: in der KI-Suche bleiben, dem Training widersprechen oder beides
- robots.txt mit getrennten Regeln für Trainings- und Suchbots aktualisieren
- Bots, die die robots.txt ignorieren, auf dem Server blockieren oder drosseln
- Alles, was sich als Googlebot ausgibt, vor dem Vertrauen verifizieren
- Full-Page-Caching aktivieren, damit wiederholte Crawls günstig sind
- KI-Crawler-Einstellungen und Standardwerte Ihres CDN überprüfen
Hosting, das sich von Bots nicht ausbremsen lässt
Bot-Traffic gehört inzwischen ganz normal zum Betrieb einer Website, daher muss Ihr Hosting ihn abfangen können. Das Hosting von WebGee läuft auf LiteSpeed-Webservern, die LiteSpeed Cache unterstützen: einen Full-Page-Cache, der wiederholte Anfragen ausliefert, ohne PHP anzurühren. Sie erhalten volle Kontrolle über .htaccess und robots.txt, Zugriff auf Ihre Raw-Logs, Cloudflare-CDN-Integration beim cPanel-Cloud-Hosting sowie Support rund um die Uhr von Technikern, die Ihnen helfen, Ihre Logs zu lesen und ein Crawler-Problem zu erkennen.
Wenn Bots Ihre Website regelmäßig an ihre Ressourcenlimits bringen, bietet Ihnen ein Cloud-Server dedizierte Ressourcen und volle Kontrolle über nginx, Rate-Limits und Firewalls.
Häufige Fragen
Verschwindet meine Website aus ChatGPT, wenn ich GPTBot blockiere?
Nein. GPTBot sammelt Trainingsdaten. Die ChatGPT-Suche nutzt OAI-SearchBot. Lassen Sie OAI-SearchBot also zu, wenn Sie in den Suchergebnissen von ChatGPT erscheinen möchten.
Wirkt sich das Blockieren von Google-Extended auf mein Google-Ranking aus?
Nein. Google-Extended steuert nur, ob Ihre Inhalte für das Training und Grounding von Gemini verwendet werden. Laut Google hat es keinen Einfluss auf die Aufnahme in die Google-Suche oder auf Rankings.
Halten sich alle KI-Bots an die robots.txt?
Nein. Die großen Trainings- und Such-Crawler geben an, dies zu tun, doch von Nutzern ausgelöste Abrufe tun es möglicherweise nicht, und einige Crawler wie Bytespider ignorieren sie Berichten zufolge häufig. Nutzen Sie für diese Serverregeln oder Ihr CDN.
Woran erkenne ich, ob Bots meine Website verlangsamen?
Zählen Sie in Ihren Access-Logs die Anfragen pro User-Agent und vergleichen Sie Spitzenzeiten mit Ihrer Ressourcennutzung. In cPanel prüfen Sie unter Resource Usage, ob zu denselben Zeiten Limits erreicht wurden.
Was hat sich bei Cloudflare am 15. September 2026 geändert?
Für neue Websites sowie für Websites im Free-Plan, deren Einstellungen nicht geändert wurden, lässt Cloudflare Such-Crawler nun standardmäßig zu, blockiert aber KI-Training und Agent-Nutzung auf Seiten mit Werbung.
