
Im vergangenen Jahr wurde llms.txt als schnelle Lösung für die KI-Suche angepriesen: Fügen Sie Ihrer Website eine Textdatei hinzu, und ChatGPT, Gemini und Perplexity verstehen Sie besser. Tausende Websites haben inzwischen eine solche Datei, und SEO-Tools markieren mittlerweile Websites, denen sie fehlt.
Die Daten aus 2026 erzählen eine andere Geschichte. Dieser Leitfaden erklärt, was llms.txt ist, was die Fakten darüber verraten, wer die Datei tatsächlich liest, wo sie wirklich hilft und was letztlich darüber entscheidet, ob KI-Suchtools Ihre Website finden und zitieren.
Das Wichtigste
- llms.txt ist eine Markdown-Datei, die KI-Tools eine kuratierte Übersicht Ihrer Website bietet. Sie wurde im September 2024 vorgeschlagen.
- Laut Google ignoriert die Google-Suche llms.txt, und 97 % der Dateien wurden im Mai 2026 kein einziges Mal abgerufen (Ahrefs).
- Sie hilft KI-Coding-Assistenten beim Lesen von Entwicklerdokumentation.
- Die Sichtbarkeit in der KI-Suche hängt davon ab, die richtigen Crawler zuzulassen, Inhalte im HTML bereitzustellen und solide SEO-Grundlagen zu haben.
- Wenn Sie Trainings-Bots wie GPTBot blockieren, verschwinden Sie nicht aus der ChatGPT-Suche – wenn Sie OAI-SearchBot blockieren, schon.
Die Kurzantwort llms.txt hilft Ihnen nicht dabei, in der KI-Suche zu ranken oder zitiert zu werden. Laut Google ignoriert die Google-Suche die Datei, und Logdaten zeigen, dass KI-Such-Crawler sie so gut wie nie abrufen. Nützlich ist sie für eine Zielgruppe: KI-Coding-Assistenten, die Entwicklerdokumentation lesen. Wenn Sie eine Dokumentation oder eine API betreiben, legen Sie eine an. Andernfalls investieren Sie Ihre Zeit besser in die unten beschriebenen Grundlagen.
Was ist llms.txt?
llms.txt wurde im September 2024 von Jeremy Howard von Answer.AI vorgeschlagen. Es handelt sich um eine Markdown-Datei unter /llms.txt, die KI-Tools eine kurze, kuratierte Übersicht Ihrer Website liefert: worum es geht und Links zu den wichtigsten Seiten – idealerweise als sauberes Markdown statt als HTML voller Menüs und Skripte.
Das Format ist einfach. Nur der H1-Titel ist Pflicht:
- eine H1 mit dem Namen der Website oder des Projekts;
- ein Blockzitat mit einer einzeiligen Zusammenfassung;
- optionale Absätze mit zusätzlichem Kontext;
- H2-Abschnitte mit Linklisten, jeweils optional gefolgt von einer kurzen Anmerkung;
- per Konvention ein Abschnitt Optional für Links, die ein KI-Tool bei Platzmangel überspringen kann.
# Example Hosting

> Example Hosting provides managed WordPress and VPS hosting with data centres in the EU and US.

Support is available 24/7. Prices are listed in USD.

## Docs

- [Getting started](https://example.com/docs/start.md): Set up your first site
- [DNS guide](https://example.com/docs/dns.md): Point a domain to your hosting

## Optional

- [Changelog](https://example.com/changelog.md)
Version 2 der Spezifikation, veröffentlicht im August 2026, brachte einige Neuerungen: Markdown-Kopien von Seiten können sowohl unter page.md als auch unter page.html.md liegen, Dateien können sich auf einen Unterordner wie /docs/llms.txt beziehen, und Seiten können über standardmäßige Link-Tags oder -Header auf ihre Markdown-Version und auf die zugehörige llms.txt verweisen. Ein verbreiteter Irrtum: llms-full.txt, eine einzelne Datei mit Ihrer gesamten Dokumentation, ist nicht Teil der Spezifikation. Es handelt sich um eine Konvention, die von Dokumentationsplattformen wie Mintlify eingeführt wurde.
Wer nutzt llms.txt?
Die Verbreitung ist rasant gewachsen. Originality.ai zählte im Juni 2025 4.088 llms.txt-Dateien und im Mai 2026 bereits 36.120 – ein Anstieg um das 8,8-Fache – unter den mehr als drei Millionen Websites, die das Unternehmen beobachtet. Das sind dennoch nur rund 1 % davon. Ahrefs stellte fest, dass 28 % der 137.000 Domains, die sein Analyseprodukt nutzen, eine solche Datei veröffentlichen – allerdings handelt es sich dabei überwiegend um SEO-affine Websites.
Yoast SEO, AIOSEO, Wix, Mintlify und GitBook können die Datei automatisch für Sie erzeugen, und Chromes Lighthouse hat im Mai 2026 eine llms.txt-Prüfung in seine neue Kategorie „Agentic Browsing“ aufgenommen. Diese Prüfung bemängelt nur eine fehlerhafte Datei; eine fehlende Datei gilt als „nicht zutreffend“. Auch die KI-Unternehmen veröffentlichen llms.txt-Dateien, allerdings nur für ihre Entwicklerdokumentation.
Lesen KI-Suchmaschinen die Datei tatsächlich?
An dieser Stelle fällt der Hype in sich zusammen.
Google: „Die Google-Suche ignoriert sie“
Googles Leitfaden von 2026 zur Optimierung für seine generativen KI-Funktionen führt llms.txt unter den Dingen auf, die Sie ignorieren können. Darin heißt es, dass Sie keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markdown benötigen, um in der Google-Suche oder ihren KI-Funktionen zu erscheinen, „da die Google-Suche selbst sie nicht verwendet“. Ein Update vom Juni 2026 ergänzt, dass es in Ordnung ist, eine solche Datei für andere Dienste zu erstellen, sie Ihrer Sichtbarkeit in der Google-Suche aber „weder schadet noch nützt“. Googles John Mueller hat sie mit dem alten Keywords-Meta-Tag verglichen.
OpenAI, Anthropic und Perplexity: Schweigen
Keine der Crawler-Dokumentationen von OpenAI, Anthropic oder Perplexity erwähnt llms.txt. Ausgeschlossen haben sie es nicht, aber keine große KI-Plattform hat sich verpflichtet, die Datei zu lesen.
Die Logs: 97 % der Dateien wurden nie abgerufen
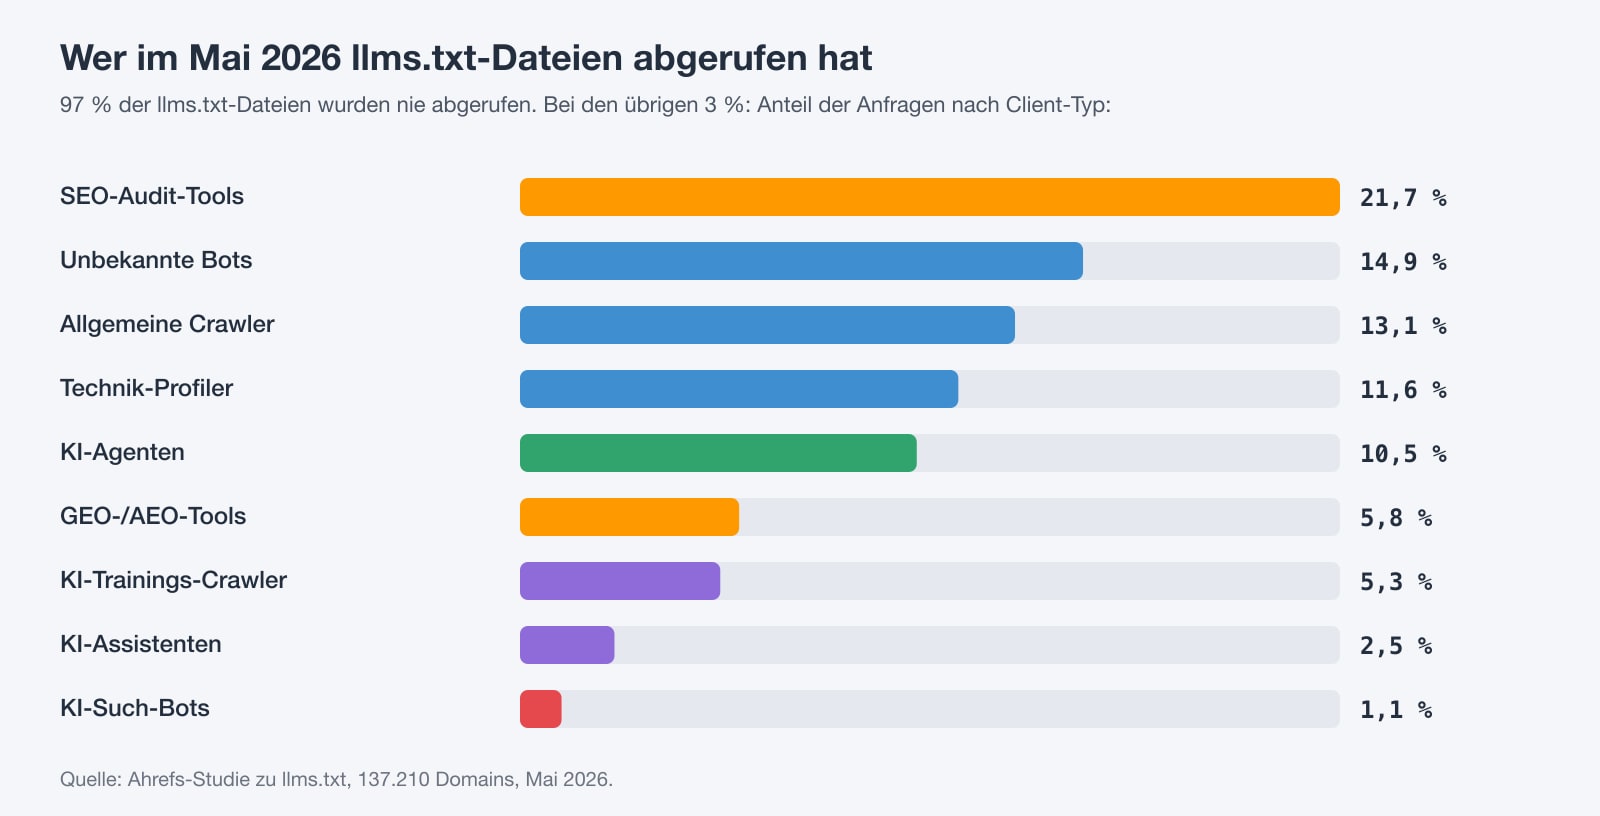
Die eindeutigsten Belege stammen von Ahrefs: Das Unternehmen analysierte im Mai 2026 llms.txt-Abrufe auf 137.210 Domains. Das Ergebnis: 97 % der llms.txt-Dateien erhielten in diesem Monat keinerlei Traffic. Sie wurden überhaupt nicht abgerufen.
Bei den 3 %, die abgerufen wurden, stammten die meisten Anfragen von SEO-Audit-Tools, allgemeinen Crawlern und Website-Profilern. KI-Such- und Retrieval-Bots wie OAI-SearchBot und PerplexityBot machten gerade einmal 1,1 % der Anfragen aus – insgesamt ein paar hundert Abrufe. Und auf Websites ohne llms.txt fragten KI-Bots nie danach: Sie suchen also gar nicht aktiv nach der Datei.
Prüfen Sie Ihre eigenen Logs
Sie müssen sich nicht auf andere verlassen. Wenn Ihre Website eine llms.txt hat, sehen Sie damit, wer sie abgerufen hat:
# Who fetched llms.txt, by user agent (nginx/Apache combined log format)
grep -h '"GET /llms' /var/log/nginx/access.log* 2>/dev/null \
  | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -20

# cPanel: per-domain logs live under ~/access-logs/
zgrep -h '"GET /llms' ~/access-logs/* | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn
Wo llms.txt tatsächlich hilft: KI-Coding-Assistenten
Es gibt eine Gruppe von Tools, die die Datei nutzt: KI-Coding-Assistenten wie Claude Code und Cursor sowie darauf aufbauende Tools. In den Ahrefs-Daten entfielen 10,5 % der llms.txt-Anfragen auf KI-Agenten – weit mehr als auf KI-Such- und Assistenz-Bots zusammen (3,6 %) –, und Claude Code war nach dem Trainings-Crawler von OpenAI das aktivste namentlich erfasste KI-Tool. Wenn eine Entwicklerin oder ein Entwickler eines dieser Tools auf Ihre Dokumentation ansetzt, findet es dank eines übersichtlichen Index aus Markdown-Seiten schnell die richtige API-Referenz und verbraucht dabei deutlich weniger Tokens: Cloudflare hat für eine Seite 16.180 Tokens als HTML und 3.150 als Markdown gemessen – rund 80 % weniger.
Die Faustregel ist also einfach:
- Sie veröffentlichen Entwicklerdokumentation, eine API oder ein Softwareprodukt: Legen Sie eine llms.txt und Markdown-Versionen Ihrer Dokumentationsseiten an. Der Aufwand ist gering, und Sie erleichtern Entwicklern, die mit KI-Tools arbeiten, das Leben.
- Sie betreiben eine Unternehmenswebsite, einen Shop oder einen Blog: Die Datei schadet nicht, und wenn Ihr SEO-Plugin sie automatisch erzeugt, lassen Sie die Funktion ruhig aktiviert. Erwarten Sie aber keine Veränderung beim Traffic aus der KI-Suche.
Was Sie wirklich in die KI-Suche bringt
Laut Google muss eine Seite, um als Link in AI Overviews oder im AI Mode zu erscheinen, lediglich indexiert und für ein Snippet in der normalen Suche geeignet sein. „Es gibt keine zusätzlichen technischen Anforderungen.“ Entscheidend ist dasselbe wie bei gutem SEO – ergänzt um einige KI-spezifische Details.
1. Blockieren Sie nicht die KI-Crawler, die Sie haben möchten
Jedes KI-Unternehmen betreibt mehrere Bots mit unterschiedlichen Aufgaben. Wenn Sie den Trainings-Bot blockieren, verschwinden Sie nicht aus der KI-Suche – wenn Sie den Such-Bot blockieren, hingegen schon:
- OAI-SearchBot entscheidet, ob Sie in der ChatGPT-Suche erscheinen. GPTBot dient dem Training.
- Claude-SearchBot indexiert für die Suche von Claude; ClaudeBot dient dem Training; Claude-User ruft Seiten ab, wenn ein Nutzer danach fragt.
- PerplexityBot speist die Perplexity-Suche und wird nicht für das Training verwendet.
- Google-Extended ist kein Crawler. Es handelt sich um einen robots.txt-Schalter für das Training und Grounding von Gemini, der sich nicht auf die Google-Suche oder AI Overviews auswirkt. Um AI Overviews einzuschränken, verwenden Sie
nosnippetodermax-snippet. - Applebot-Extended steuert lediglich, ob Apple Inhalte für das Training nutzen darf.
Hier eine robots.txt, mit der Sie in der KI-Suche sichtbar bleiben und gleichzeitig dem Modelltraining widersprechen:
# Allow AI search and user-requested fetches
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Allow: /

# Opt out of model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
Prüfen Sie auch Firewall und CDN Google weist darauf hin, dass das Crawling sowohl in der robots.txt als auch von etwaigen CDN- oder Hosting-Infrastrukturen erlaubt sein muss. Bot-Schutzregeln eines CDN oder Sicherheits-Plugins können KI-Such-Crawler unbemerkt blockieren, selbst wenn die robots.txt sie zulässt. Prüfen Sie daher auch diese Einstellungen.
Mit den Content Signals von Cloudflare können Sie Ihre Präferenzen noch genauer festlegen. Dabei wird der robots.txt eine Zeile wie Content-Signal: search=yes, ai-input=yes, ai-train=no hinzugefügt. Die IETF arbeitet an einem Standardvokabular für KI-Nutzungspräferenzen, das sich allerdings noch im Entwurfsstadium befindet.
2. Stellen Sie Ihre Inhalte im HTML bereit
Die meisten KI-Crawler führen kein JavaScript aus. Eine Studie von Vercel aus dem Jahr 2024 ergab, dass – abgesehen von denen von Google und Apple – keiner der untersuchten großen KI-Crawler JavaScript renderte. Wenn Ihre Texte, Preise oder Produktdetails erst nach der Ausführung von Skripten erscheinen, sehen KI-Tools möglicherweise eine leere Seite. Setzen Sie auf serverseitiges Rendering oder ein CMS wie WordPress, das die Inhalte im HTML ausgibt. So prüfen Sie, was ein Crawler sieht:
# Fetch the raw HTML the way a crawler does, then look for your key text
curl -s -A "OAI-SearchBot/1.0" https://example.com/pricing | grep -i "per month"
3. Sorgen Sie für solide Grundlagen
- Klare, konkrete Seiten, die echte Fragen beantworten – mit Überschriften und Listen.
- Strukturierte Daten, die mit den sichtbaren Inhalten der Seite übereinstimmen. Für die KI-Suche sind sie nicht erforderlich, helfen aber bei Rich Results.
- Eine Sitemap, gute interne Verlinkung und eine schnelle, zuverlässige Website. Googles Leitlinien nennen eine geringere Latenz als Teil einer guten Nutzererfahrung.
- Echte Expertise und ein Ruf, der dazu führt, dass andere Websites Sie zitieren.
So handhaben wir es bei WebGee
Wir veröffentlichen eine llms.txt auf webgee.com, weil sie sich mit wenig Aufwand pflegen lässt und den KI-Tools hilft, die sie tatsächlich lesen. Unsere robots.txt legt außerdem unsere KI-Präferenzen mit Content Signals fest. Die Arbeit, auf die es wirklich ankommt, ist aber der unspektakuläre Teil: serverseitig gerenderte Seiten, schnelles Hosting, saubere strukturierte Daten und Inhalte, die von Menschen geschrieben werden, die tagtäglich Hosting betreiben.
Genau dafür ist auch unser Hosting ausgelegt. LiteSpeed-Webserver mit Caching halten Seiten für Menschen und Crawler gleichermaßen schnell, und Sie haben die volle Kontrolle über Ihre robots.txt-, CDN- und Sicherheitseinstellungen – mit 24/7-Support, falls Sie Hilfe beim Auswerten Ihrer Logs benötigen.
Häufige Fragen
Verbessert llms.txt mein Ranking bei Google oder in den AI Overviews?
Nein. Google erklärt, dass die Google-Suche einschließlich ihrer KI-Funktionen llms.txt ignoriert und eine solche Datei Ihrer Sichtbarkeit weder nützt noch schadet.
Liest ChatGPT llms.txt?
OpenAI hat nie angegeben, llms.txt zu nutzen, und Logdaten aus 2026 zeigen, dass der Such-Crawler von OpenAI die Datei so gut wie nie abruft. Die ChatGPT-Suche verwendet OAI-SearchBot, den Sie in der robots.txt zulassen müssen, um dort zu erscheinen.
Ist llms.txt schädlich?
Nein. Die Veröffentlichung ist unbedenklich und nützlich, wenn Sie Entwicklerdokumentation anbieten. Erwarten Sie nur keinen zusätzlichen Traffic aus der KI-Suche.
Was ist llms-full.txt?
Eine einzelne Datei, die die gesamte Dokumentation einer Website in Markdown enthält. Sie ist eine Konvention von Dokumentationsplattformen wie Mintlify und nicht Teil der llms.txt-Spezifikation.
Wie verhindere ich, dass KI-Modelle mit meinen Inhalten trainiert werden, bleibe aber in der KI-Suche sichtbar?
Sperren Sie in der robots.txt Trainings-Bots wie GPTBot, ClaudeBot, Google-Extended und Applebot-Extended und lassen Sie Such-Bots wie OAI-SearchBot, Claude-SearchBot und PerplexityBot zu.
