
2026 年 5 月的某一天,互联网跨过了一道分水岭:自动化流量超过了真人流量。承载着全球约五分之一网络流量的 Cloudflare 原本预计这一刻会在 2027 年下半年到来,而 AI 爬虫和 AI 代理让它提前了一年多。6 月初,Cloudflare 的 CEO 表示,网页请求中约有 57% 来自机器人。
对网站所有者来说,这不只是一个统计数字。每一次机器人请求消耗的 CPU、内存和带宽都与真实访客无异,而在许多网站上,这部分负载中越来越大的比例来自几乎不带回任何访客的 AI 爬虫。本指南将介绍如何查看您的流量中有多少来自机器人、应该放行哪些,以及如何管控其余的爬虫。
要点速览
- 据 Cloudflare 统计,自动化流量已于 2026 年 5 月超过真人流量。
- 截至 2026 年 6 月,AI 训练占爬虫请求的 52%,而大多数训练爬虫几乎不会带回流量。
- 机器人请求会实实在在地消耗 CPU、内存和带宽,在共享主机上还可能引发 503 错误。
- 在 robots.txt 中屏蔽训练爬虫、放行搜索爬虫,并对无视规则的机器人在服务器端强制限制。
- 机器人抓取的大部分内容并未变化,因此开启全页缓存可以大幅降低重复抓取的成本。
这一转变有多大?
Cloudflare 公布的 2026 年数据显示了变化之快:
- 来自 AI 代理的每日请求量一年内增长超过 1,700%。
- 截至 2026 年 6 月,AI 训练占爬虫请求的 52%,而 2025 年春季这一比例仅为 22%。
- 守规矩的机器人所抓取的内容中,超过一半自上次访问以来没有任何变化。
- 在一些被频繁抓取的类别中,由于人们直接从 AI 工具获取答案而不再点击访问网站,真人流量在不到一年内下降了多达 40%。
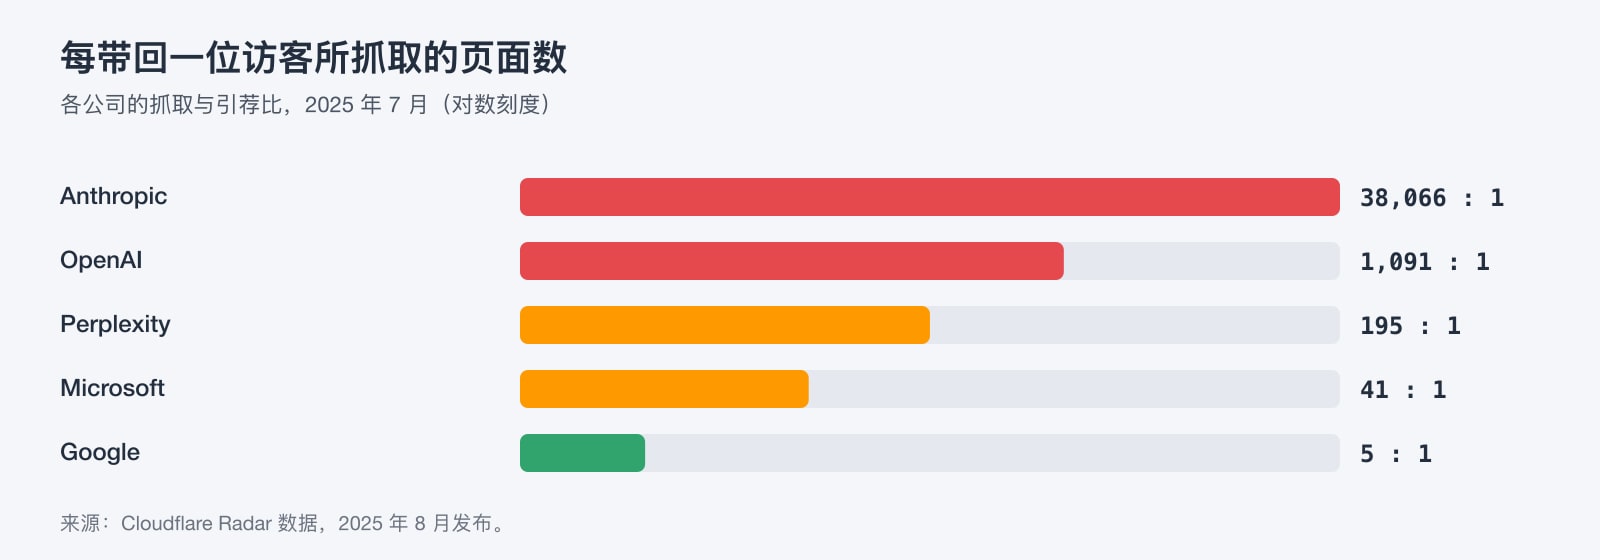
这种失衡在 Cloudflare 所称的“抓取与引荐比”中体现得最为明显:即某家公司的机器人每抓取多少个页面,其产品才会带回 1 位访客。2025 年 7 月,Google 每引荐 1 位访客约抓取 5 个页面,OpenAI 约为 1,091 个,Anthropic 则约为 38,066 个。搜索引擎抓取网页是为了给您带来流量,而大多数 AI 训练爬虫并不会。
网站所有者要付出什么代价
一些公开了数据的组织提供了最直观的例子:
- Read the Docs 报告称,2024 年 5 月单个爬虫下载了 73 TB 的文件,其中近 10 TB 发生在同一天,带宽费用超过 5,000 美元。屏蔽 AI 爬虫后,其每日下载带宽减少了 75%。
- Wikimedia 发现,机器人约占页面浏览量的 35%,却占其最耗资源流量的至少 65%,原因是爬虫请求的往往是不在缓存中的页面。
- SourceHut 的创始人表示,他有时要花掉整整一周的工作时间来对付无视 robots.txt 的爬虫,每周还会出现数十次短暂宕机。
在规模较小的网站上,代价会以另一种形式出现。在共享主机上,每一次请求都会计入账户的资源限制。爬虫对未缓存页面的集中请求可能耗尽您的 PHP 进程,导致真实访客遇到 503 错误或访问变慢,这与我们在 LVE 限制与 503 错误指南中介绍的症状相同。在 VPS 或云服务器上,则表现为 CPU 飙升和带宽占用增加。
第 1 步:了解有多少流量来自机器人
Web 服务器的访问日志会记录每次请求的用户代理。以下命令可以按机器人统计请求数和带宽:
# Requests per AI and search bot
awk -F'"' '{print $6}' access.log \
  | grep -oiE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|Googlebot|Bingbot|Applebot|meta-externalagent|Bytespider|CCBot|Amazonbot' \
  | sort | uniq -c | sort -rn

# Bandwidth per AI crawler
awk -F'"' '{split($3,a," "); ua=$6;
  if (match(ua,/GPTBot|ClaudeBot|Bytespider|CCBot|Amazonbot|meta-externalagent/))
    b[substr(ua,RSTART,RLENGTH)]+=a[2]}
  END {for (k in b) printf "%-20s %.1f MB\n", k, b[k]/1048576}' access.log

# The 20 busiest user agents overall
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20
在 cPanel 主机上,原始访问日志位于 Metrics > Raw Access,也可以通过 SSH 在 ~/access-logs/ 中找到。在 VPS 上,日志通常位于 /var/log/nginx/ 或 /var/log/apache2/。
第 2 步:弄清应该放行哪些机器人
大多数 AI 公司会分别运行用于训练、用于搜索以及在用户提问时抓取页面的不同机器人。屏蔽错了可能会让您从 AI 搜索中消失,因此有必要了解它们的区别:
- 训练爬虫:GPTBot(OpenAI)、ClaudeBot(Anthropic)、meta-externalagent(Meta)、CCBot(Common Crawl)、Amazonbot(Amazon)和 Bytespider(字节跳动)。屏蔽它们不会影响您在搜索中的曝光。
- AI 搜索爬虫:OAI-SearchBot(ChatGPT 搜索)、Claude-SearchBot 和 PerplexityBot。屏蔽它们后,您将不会出现在相应的 AI 搜索结果中。
- 用户触发的抓取程序:ChatGPT-User、Claude-User 和 Perplexity-User 会因为有人询问某个页面而去抓取它。OpenAI 和 Perplexity 表示,由于请求是由真人发起的,这些程序可能不会遵守 robots.txt。
- 控制标记,而非爬虫:Google-Extended 和 Applebot-Extended 本身并不抓取任何内容。它们用于告诉 Google 和 Apple,其常规爬虫抓取的内容能否用于 AI 训练。屏蔽它们不会影响 Google 搜索或 Apple 的搜索功能。
第 3 步:在 robots.txt 中设置规则
对大多数企业来说,比较合理的默认做法是:保持在搜索和 AI 搜索中的可见性,同时拒绝用于训练:
# Opt out of AI model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: CCBot
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /

# Stay in AI search
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

# Everyone else, including Googlebot and Bingbot
User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
Anthropic、Common Crawl 和 Bing 还支持 Crawl-delay 指令(例如 Crawl-delay: 5),用于放慢抓取速度而非直接屏蔽。Google 和 Amazon 会忽略该指令。
robots.txt 只是请求,而不是门锁 来自 OpenAI、Anthropic、Google 等公司的守规矩爬虫会遵守 robots.txt,但没有任何机制能强制机器人遵守。用户触发的抓取程序可能会跳过它,据广泛报道 Bytespider 会无视它;2025 年,Cloudflare 还报告称 Perplexity 使用未声明的、伪装成浏览器的用户代理进行抓取(Perplexity 对此提出异议)。对于不守规矩的机器人,请在服务器端强制限制。
第 4 步:在服务器端强制限制
Apache、LiteSpeed 和 cPanel 主机(.htaccess)
在 Apache 和 LiteSpeed 上(包括 WebGee cPanel 主机和 WordPress 主机),您可以在 .htaccess 中拒绝特定机器人:
# .htaccess: refuse crawlers you don't want, with a 403
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (Bytespider|CCBot|meta-externalagent) [NC]
RewriteRule .* - [F,L]
nginx:对 AI 爬虫限速而不是屏蔽
在您自己的 VPS 上,nginx 可以放慢 AI 爬虫的速度,同时不影响真实用户和搜索引擎。来自其他用户代理的请求会得到一个空键,因此永远不会被限速:
# http {} block
map $http_user_agent $ai_bot {
    default "";
    ~*(GPTBot|ClaudeBot|CCBot|Bytespider|Amazonbot|meta-externalagent|PerplexityBot) $binary_remote_addr;
}
limit_req_zone $ai_bot zone=aibots:10m rate=30r/m;
limit_req_status 429;

# server {} or location / {}
limit_req zone=aibots burst=10 nodelay;
核实“Googlebot”是否真的来自 Google
用户代理很容易伪造,抓取程序常常冒充 Googlebot 来绕过规则。验证方法是先进行反向 DNS 查询,再进行正向查询,确认返回的是同一个 IP。OpenAI、Anthropic 和 Perplexity 则以 JSON 文件的形式公布了各自爬虫的 IP 范围。
# Reverse lookup: a real Googlebot resolves to googlebot.com or google.com
host 66.249.66.1
# crawl-66-249-66-1.googlebot.com

# Forward lookup must return the same IP
host crawl-66-249-66-1.googlebot.com
# 66.249.66.1
第 5 步:启用缓存,降低机器人带来的开销
既然机器人抓取的内容中有一半以上自上次访问后没有变化,最省钱的解决办法往往就是全页缓存。缓存的页面直接从内存或磁盘提供,无需运行 PHP 或查询数据库,因此即使爬虫集中访问,也几乎不会造成影响。在 WordPress 上,只要在 LiteSpeed 服务器上启用 LiteSpeed Cache 插件即可实现。在其他技术栈上,可以使用 nginx FastCGI 缓存、Varnish 或 CDN 缓存。
第 6 步:使用 CDN 的 AI 管控功能
如果您的网站使用 Cloudflare,现在可以按用途进行管控。自 2026 年 7 月起,包括 Free 在内的所有套餐都可以分别针对搜索、代理使用和训练来放行或屏蔽爬虫,也可以只在含有广告的页面上屏蔽。2026 年 9 月 15 日,Cloudflare 更改了新网站以及未修改过相关设置的 Free 套餐网站的默认设置:放行搜索,但在含有广告的页面上屏蔽训练和代理使用。对于将搜索和训练混在一起、不给您选择余地的爬虫,也会在这些页面上被屏蔽。
如果您在使用 Cloudflare,请立即检查这些设置。新的默认设置可能已经在您的网站上生效,而您或许更倾向于其他选项。Cloudflare 还允许您在 robots.txt 中添加 Content Signals(例如 Content-Signal: search=yes, ai-train=no)来声明您的偏好。
AI 机器人管控清单
- 在访问日志中统计机器人的请求数和带宽
- 做出决定:保留 AI 搜索曝光、拒绝用于训练,或两者兼顾
- 更新 robots.txt,为训练爬虫和搜索爬虫分别设置规则
- 在服务器端屏蔽或限速无视 robots.txt 的机器人
- 对自称 Googlebot 的请求先核实再信任
- 开启全页缓存,降低重复抓取的成本
- 检查 CDN 的 AI 爬虫设置及默认值
不让机器人拖慢网站的主机服务
机器人流量如今已是网站运营的常态,因此您的主机需要能够承受住它。WebGee 主机运行在 LiteSpeed Web 服务器上,支持 LiteSpeed Cache:这是一种全页缓存,可在不调用 PHP 的情况下响应重复请求。您可以完全掌控 .htaccess 和 robots.txt,查看原始日志;cPanel 云主机还集成了 Cloudflare CDN,并提供 7×24 小时工程师支持,帮助您解读日志、发现爬虫问题。
如果机器人经常让您的网站触及资源限制,云服务器可以为您提供独享资源,并让您完全掌控 nginx、限速规则和防火墙。
常见问题
屏蔽 GPTBot 会让我的网站从 ChatGPT 中消失吗?
不会。GPTBot 用于收集训练数据,而 ChatGPT 搜索使用的是 OAI-SearchBot。如果您希望出现在 ChatGPT 搜索结果中,请放行 OAI-SearchBot。
屏蔽 Google-Extended 会影响我的 Google 排名吗?
不会。Google-Extended 只控制您的内容是否用于 Gemini 的训练和信息检索(grounding)。Google 表示,它不会影响网站在 Google 搜索中的收录或排名。
所有 AI 机器人都会遵守 robots.txt 吗?
不会。主流的训练和搜索爬虫声称会遵守,但由用户触发的抓取程序可能不遵守,而且据广泛报道,Bytespider 等部分爬虫会无视它。对于这类爬虫,请使用服务器规则或 CDN 进行管控。
如何判断机器人是否拖慢了我的网站?
在访问日志中按用户代理(user agent)统计请求数,并将访问高峰与资源使用情况进行对比。如果使用 cPanel,可以在“资源使用情况”(Resource Usage)中查看同一时段是否触及资源限制。
2026 年 9 月 15 日,Cloudflare 做了哪些调整?
对于新网站,以及未修改过相关设置的 Free 套餐网站,Cloudflare 现在默认放行搜索爬虫,但在含有广告的页面上屏蔽 AI 训练和代理使用。
