
过去一年里,llms.txt 一直被宣传为解决 AI 搜索问题的捷径:只要在网站上添加一个文本文件,ChatGPT、Gemini 和 Perplexity 就能更好地理解你的网站。成千上万的网站已经加上了它,一些 SEO 工具甚至会把没有这个文件的网站标记出来。
然而,2026 年的数据讲述了一个不同的故事。本指南将介绍 llms.txt 是什么、现有证据显示到底谁在读取它、它真正有用的场景,以及究竟是什么决定了 AI 搜索工具能否找到并引用你的网站。
要点速览
- llms.txt 是一个 Markdown 文件,为 AI 工具提供一份精选的网站导览,于 2024 年 9 月被提出。
- Google 表示其搜索会忽略 llms.txt;据 Ahrefs 统计,2026 年 5 月有 97% 的 llms.txt 文件零请求。
- 它确实能帮助 AI 编程助手阅读开发者文档。
- AI 搜索可见度取决于是否放行正确的爬虫、内容是否直接呈现在 HTML 中,以及扎实的 SEO 基础。
- 屏蔽 GPTBot 等训练爬虫并不会让你从 ChatGPT 搜索中消失,但屏蔽 OAI-SearchBot 会。
简短回答 llms.txt 并不能帮你在 AI 搜索中获得排名或被引用。Google 表示其搜索会忽略它,日志数据也显示 AI 搜索爬虫几乎从不抓取它。它只对一类用户有用:阅读开发者文档的 AI 编程助手。如果你运营的是文档或 API,那就加一个;否则,不如把时间花在下文介绍的基础工作上。
什么是 llms.txt?
llms.txt 由 Answer.AI 的 Jeremy Howard 于 2024 年 9 月提出。它是一个位于 /llms.txt 的 Markdown 文件,为 AI 工具提供一份简短的精选网站导览:说明网站是做什么的,并链接到最重要的页面,这些页面最好是干净的 Markdown 格式,而不是充斥着菜单和脚本的 HTML。
它的格式很简单,只有 H1 标题是必需的:
- 一个包含网站或项目名称的 H1 标题;
- 一段包含一句话简介的引用块;
- 可选的段落,用于补充背景信息;
- 若干 H2 小节,每节包含一组链接,每个链接后可附一段简短说明;
- 按照惯例,还可以有一个 Optional 小节,列出 AI 工具在篇幅有限时可以跳过的链接。
# Example Hosting

> Example Hosting provides managed WordPress and VPS hosting with data centres in the EU and US.

Support is available 24/7. Prices are listed in USD.

## Docs

- [Getting started](https://example.com/docs/start.md): Set up your first site
- [DNS guide](https://example.com/docs/dns.md): Point a domain to your hosting

## Optional

- [Changelog](https://example.com/changelog.md)
2026 年 8 月发布的第 2 版规范新增了几项内容:页面的 Markdown 副本除了 page.html.md,也可以放在 page.md;文件可以只覆盖某个子目录,例如 /docs/llms.txt;页面还可以通过标准的 Link 标签或响应头,指向自己的 Markdown 版本以及覆盖它的 llms.txt。有一种常见的误解需要澄清:llms-full.txt(一个包含全部文档的单一文件)并不属于该规范,而是由 Mintlify 等文档平台引入的惯例。
哪些网站采用了它?
它的普及速度很快。Originality.ai 在其追踪的 300 多万个网站中统计到,2025 年 6 月有 4,088 个 llms.txt 文件,到 2026 年 5 月已增至 36,120 个,增长了 8.8 倍。但这仍然只占这些网站的约 1%。Ahrefs 发现,在使用其分析产品的 137,000 个域名中,有 28% 发布了 llms.txt,不过这些大多是重视 SEO 的网站。
Yoast SEO、AIOSEO、Wix、Mintlify 和 GitBook 都能帮你自动生成这个文件,Chrome 的 Lighthouse 也在 2026 年 5 月于新增的“Agentic Browsing”类别中加入了 llms.txt 检查项。不过这项检查只会标记出错的文件;缺少该文件则被视为“不适用”。各家 AI 公司自己也发布了 llms.txt 文件,但仅限于其开发者文档。
AI 搜索引擎真的会读取它吗?
炒作在这里不攻自破。
Google:“Google 搜索会忽略它们”
Google 在 2026 年发布的生成式 AI 功能优化指南中,把 llms.txt 列为可以忽略的内容之一。指南指出,要出现在 Google 搜索或其 AI 功能中,你不需要新的机器可读文件、AI 文本文件或 Markdown,“因为 Google 搜索本身并不使用它们”。2026 年 6 月的更新补充说,为其他服务创建这样的文件没有问题,但它对你在 Google 搜索中的可见度“既无害处也无帮助”。Google 的 John Mueller 曾把它比作过时的 keywords 元标签。
OpenAI、Anthropic 和 Perplexity:保持沉默
OpenAI、Anthropic 和 Perplexity 的爬虫文档中都没有提到 llms.txt。它们并未排除这种可能,但目前没有任何一家主流 AI 平台承诺会读取它。
日志数据:97% 的文件零请求
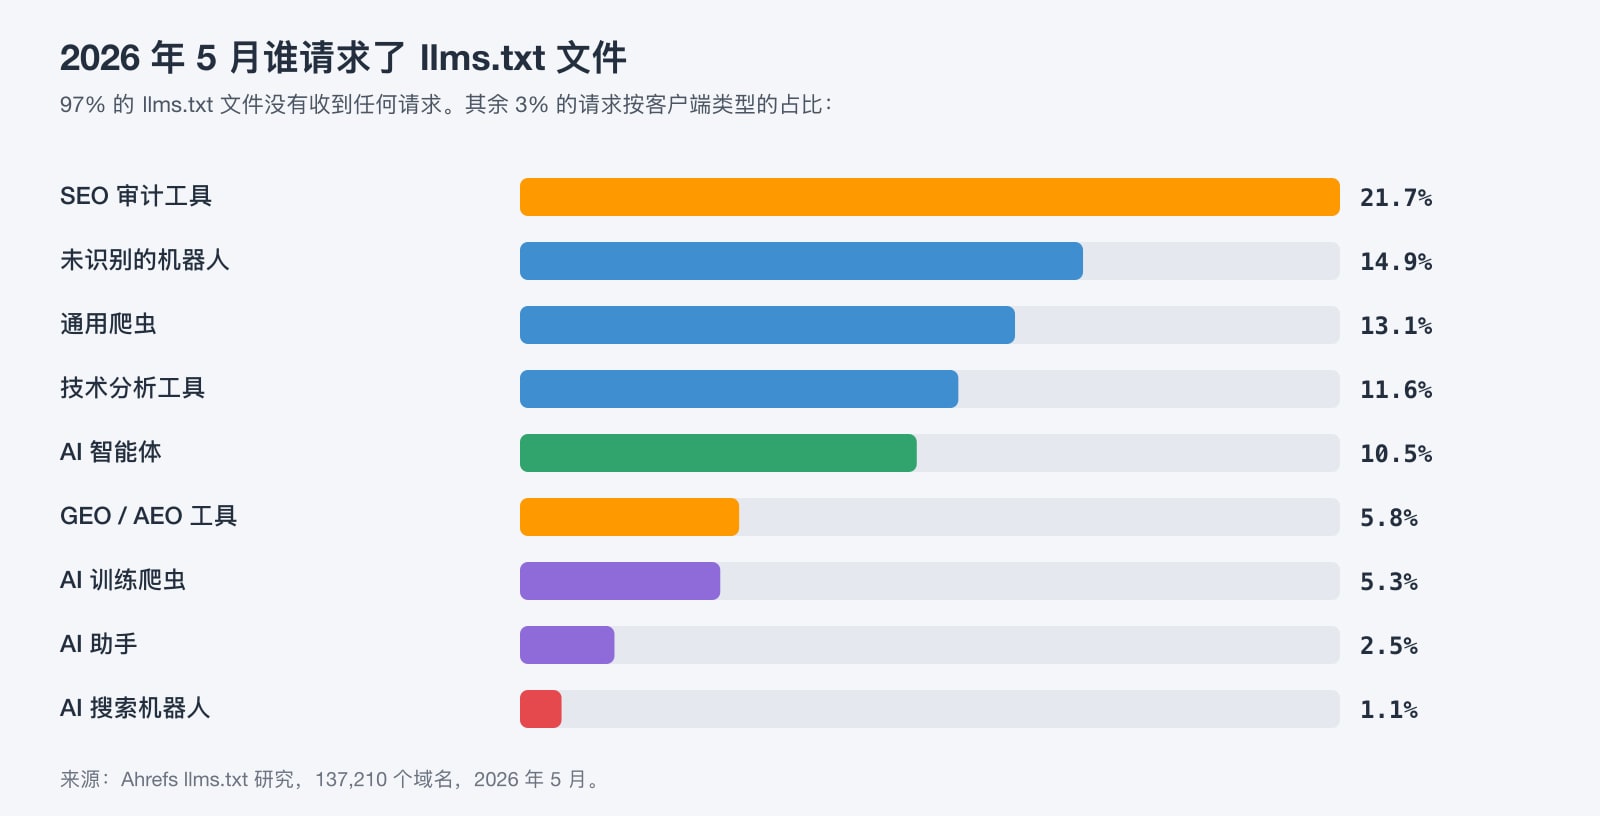
最有力的证据来自 Ahrefs,它在 2026 年 5 月分析了 137,210 个域名上的 llms.txt 请求。结论是:当月 97% 的 llms.txt 文件流量为零,完全没有任何程序抓取过它们。
在被抓取过的 3% 中,大部分请求来自 SEO 审计工具、通用爬虫和网站分析工具。OAI-SearchBot 和 PerplexityBot 等 AI 搜索与检索爬虫仅占请求总量的 1.1%,总共也就几百次抓取。而且对于没有 llms.txt 的网站,AI 爬虫从未请求过这个文件:它们根本不会主动去找。
查看你自己的日志
你不必轻信任何人的说法。如果你的网站有 llms.txt,可以用下面的方法查看都有谁请求过它:
# Who fetched llms.txt, by user agent (nginx/Apache combined log format)
grep -h '"GET /llms' /var/log/nginx/access.log* 2>/dev/null \
  | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -20

# cPanel: per-domain logs live under ~/access-logs/
zgrep -h '"GET /llms' ~/access-logs/* | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn
llms.txt 真正有用的场景:AI 编程助手
确实有一类工具会使用它:Claude Code、Cursor 等 AI 编程助手,以及基于它们构建的工具。在 Ahrefs 的数据中,AI 智能体发起了 10.5% 的 llms.txt 请求,远超 AI 搜索和助手类爬虫的总和(3.6%);在有名称的 AI 工具中,Claude Code 的活跃度仅次于 OpenAI 的训练爬虫。当开发者让这类工具读取你的文档时,一份干净的 Markdown 页面索引能让它快速找到正确的 API 参考,并大幅减少 token 消耗:Cloudflare 测得,同一个页面以 HTML 格式需要 16,180 个 token,而 Markdown 格式只需 3,150 个,减少了约 80%。
所以经验法则很简单:
- 如果你发布开发者文档、API 或软件产品:请添加 llms.txt 以及文档页面的 Markdown 版本。工作量不大,却能让使用 AI 工具的开发者轻松许多。
- 如果你运营的是企业网站、网店或博客:它没有害处,如果你的 SEO 插件会自动生成它,保持开启即可。但别指望 AI 搜索流量会因此有任何变化。
真正让你进入 AI 搜索的因素
根据 Google 的说法,页面要以链接形式出现在 AI 概览或 AI 模式中,只需在常规搜索中被编入索引并符合显示摘要的条件即可,“没有额外的技术要求”。关键因素与优质 SEO 相同,只是多了一些 AI 特有的细节。
1. 不要屏蔽你需要的 AI 爬虫
每家 AI 公司都运行着多个爬虫,它们各司其职。屏蔽训练爬虫并不会让你从 AI 搜索中消失,但屏蔽搜索爬虫会:
- OAI-SearchBot 决定你是否会出现在 ChatGPT 搜索中,GPTBot 则用于训练。
- Claude-SearchBot 为 Claude 的搜索建立索引;ClaudeBot 用于训练;Claude-User 在用户提问时抓取页面。
- PerplexityBot 为 Perplexity 搜索提供支持,不用于训练。
- Google-Extended 并不是爬虫,而是 robots.txt 中控制 Gemini 训练和信息溯源(grounding)的开关,不会影响 Google 搜索或 AI 概览。如果想限制 AI 概览,需要使用
nosnippet或max-snippet。 - Applebot-Extended 只控制 Apple 能否将内容用于训练。
下面这份 robots.txt 既能让你在 AI 搜索中保持可见,又能拒绝内容被用于模型训练:
# Allow AI search and user-requested fetches
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Allow: /

# Opt out of model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
别忘了检查防火墙和 CDN Google 指出,robots.txt 以及任何 CDN 或主机基础设施都必须允许抓取。即使 robots.txt 已放行,CDN 或安全插件中的防爬虫规则也可能在你不知情的情况下屏蔽 AI 搜索爬虫,因此请一并检查这些设置。
你还可以借助 Cloudflare 的 Content Signals 更精确地表达你的偏好,它会在 robots.txt 中添加类似 Content-Signal: search=yes, ai-input=yes, ai-train=no 的一行。IETF 正在制定一套表达 AI 使用偏好的标准词汇,但目前仍处于草案阶段。
2. 把内容直接放在 HTML 中
大多数 AI 爬虫不会执行 JavaScript。Vercel 在 2024 年的一项研究发现,在其测量的主流 AI 爬虫中,除了 Google 和 Apple 的爬虫外,没有一个会渲染 JavaScript。如果你的文字、价格或产品详情只有在脚本运行后才会显示,AI 工具看到的可能就是一个空白页面。请使用服务端渲染,或选用 WordPress 这类直接以 HTML 输出内容的 CMS。你可以这样查看爬虫看到的内容:
# Fetch the raw HTML the way a crawler does, then look for your key text
curl -s -A "OAI-SearchBot/1.0" https://example.com/pricing | grep -i "per month"
3. 打牢基础
- 页面清晰、具体,能解答真实问题,并合理使用标题和列表。
- 结构化数据与页面上可见的内容保持一致。它并非 AI 搜索的必要条件,但有助于获得富媒体搜索结果。
- 提供站点地图、良好的内部链接,以及快速、稳定的网站。Google 的指南将降低延迟列为良好页面体验的一部分。
- 具备真正的专业能力,并拥有能被其他网站引用的良好声誉。
WebGee 的做法
我们在 webgee.com 上发布了 llms.txt,因为它维护成本很低,还能为那些确实会读取它的 AI 工具提供帮助。我们的 robots.txt 也通过 Content Signals 声明了我们的 AI 偏好。但真正重要的工作其实是那些不起眼的部分:服务端渲染的页面、快速的主机、规范的结构化数据,以及由每天都在运营主机服务的专业人员撰写的内容。
这也正是我们主机服务的设计初衷。搭载缓存功能的 LiteSpeed Web 服务器无论对访客还是爬虫都能保持页面快速加载;你可以完全掌控自己的 robots.txt、CDN 和安全设置,如果需要帮忙解读日志,我们还提供 24/7 全天候支持。
常见问题
llms.txt 能提升我在 Google 或 AI 概览中的排名吗?
不能。Google 明确表示,Google 搜索(包括其 AI 功能)会忽略 llms.txt,有没有这个文件既不会提升也不会损害你的可见度。
ChatGPT 会读取 llms.txt 吗?
OpenAI 从未表示会使用 llms.txt,2026 年的日志数据也显示,OpenAI 的搜索爬虫几乎从不请求这个文件。ChatGPT 搜索使用的是 OAI-SearchBot,你必须在 robots.txt 中放行它,才能出现在搜索结果中。
llms.txt 有害吗?
没有害处。发布它不会带来任何负面影响,如果你有开发者文档,它还挺有用。只是别指望它能带来 AI 搜索流量。
llms-full.txt 是什么?
它是一个以 Markdown 格式包含网站全部文档的单一文件。这是 Mintlify 等文档平台形成的惯例,并不属于 llms.txt 规范。
如何禁止 AI 模型用我的内容训练,同时仍出现在 AI 搜索中?
在 robots.txt 中禁止 GPTBot、ClaudeBot、Google-Extended 和 Applebot-Extended 等训练爬虫,同时放行 OAI-SearchBot、Claude-SearchBot 和 PerplexityBot 等搜索爬虫。
