على مدار العام الماضي، رُوِّج لملف llms.txt على أنه الحل السريع للبحث بالذكاء الاصطناعي: أضف ملفًا نصيًا واحدًا إلى موقعك وسيفهمك ChatGPT وGemini وPerplexity بشكل أفضل. وقد أضافته آلاف المواقع، وأصبحت أدوات SEO تنبّه المواقع التي لا تملكه.
لكن بيانات 2026 تروي قصة مختلفة. يشرح هذا الدليل ماهية llms.txt، وما تقوله الأدلة عمّن يقرؤه فعلًا، وأين يفيد حقًا، وما الذي يحدد فعليًا قدرة أدوات البحث بالذكاء الاصطناعي على العثور على موقعك والاستشهاد به.
أهم النقاط
- llms.txt ملف بتنسيق Markdown يقدّم لأدوات الذكاء الاصطناعي خريطة منتقاة لموقعك، وقد اقتُرح في سبتمبر 2024.
- تقول Google إن محرك بحثها يتجاهل llms.txt، كما أن 97% من الملفات لم تتلقَّ أي طلب في مايو 2026 (وفقًا لـ Ahrefs).
- يفيد الملف بالفعل مساعدي البرمجة بالذكاء الاصطناعي في قراءة وثائق المطورين.
- يعتمد الظهور في البحث بالذكاء الاصطناعي على السماح للزواحف المناسبة، ووجود المحتوى في HTML، وأساسيات SEO قوية.
- حظر روبوتات التدريب مثل GPTBot لا يُخرجك من بحث ChatGPT، أما حظر OAI-SearchBot فيُخرجك منه.
الإجابة المختصرة لا يساعدك llms.txt على تحسين ترتيبك أو الحصول على استشهادات في البحث بالذكاء الاصطناعي. تقول Google إن محرك بحثها يتجاهله، وتُظهر بيانات السجلات أن زواحف البحث بالذكاء الاصطناعي لا تكاد تجلبه أبدًا. لكنه مفيد لفئة واحدة: مساعدو البرمجة بالذكاء الاصطناعي الذين يقرؤون وثائق المطورين. إذا كنت تدير وثائق أو واجهة برمجة تطبيقات (API)، فأضِفه. وإلا فاستثمر وقتك في الأساسيات الواردة أدناه.
ما هو llms.txt؟
اقترح Jeremy Howard من Answer.AI ملف llms.txt في سبتمبر 2024. وهو ملف بتنسيق Markdown يوضع في /llms.txt ويقدّم لأدوات الذكاء الاصطناعي خريطة قصيرة ومنتقاة لموقعك: ما هو الموقع، مع روابط إلى أهم صفحاته، ويُفضَّل أن تكون بتنسيق Markdown نظيف بدلًا من HTML المليء بالقوائم والسكربتات.
التنسيق بسيط، والعنصر الإلزامي الوحيد هو عنوان H1:
- عنوان H1 يحمل اسم الموقع أو المشروع؛
- اقتباس (blockquote) يتضمن ملخصًا في سطر واحد؛
- فقرات اختيارية تضيف سياقًا إضافيًا؛
- أقسام H2 تحتوي على قوائم روابط، ويمكن أن تلي كل رابط ملاحظة قصيرة؛
- وبحسب العُرف المتّبع، قسم Optional يضم روابط يمكن لأداة الذكاء الاصطناعي تخطيها عندما تكون المساحة المتاحة لها محدودة.
# Example Hosting

> Example Hosting provides managed WordPress and VPS hosting with data centres in the EU and US.

Support is available 24/7. Prices are listed in USD.

## Docs

- [Getting started](https://example.com/docs/start.md): Set up your first site
- [DNS guide](https://example.com/docs/dns.md): Point a domain to your hosting

## Optional

- [Changelog](https://example.com/changelog.md)
أضاف الإصدار 2 من المواصفات، المنشور في أغسطس 2026، بعض الأمور: يمكن أن توجد نسخ Markdown من الصفحات في page.md إلى جانب page.html.md، ويمكن أن تغطي الملفات مجلدًا فرعيًا مثل /docs/llms.txt، ويمكن للصفحات أن تشير إلى نسختها بتنسيق Markdown وإلى ملف llms.txt الذي يغطيها عبر وسوم Link أو ترويسات قياسية. وهناك اعتقاد شائع خاطئ: ملف llms-full.txt، وهو ملف واحد يضم جميع وثائقك، ليس جزءًا من المواصفات، بل هو عُرف أطلقته منصات التوثيق مثل Mintlify.
من الذي اعتمده؟
نما الاعتماد عليه بسرعة. فقد أحصت Originality.ai نحو 4,088 ملف llms.txt في يونيو 2025، ثم 36,120 ملفًا بحلول مايو 2026، أي بزيادة قدرها 8.8 أضعاف، من بين أكثر من ثلاثة ملايين موقع تتابعها. ومع ذلك لا يمثل هذا سوى نحو 1% منها. ووجدت Ahrefs أن 28% من 137,000 نطاق تستخدم منتجها التحليلي تنشر هذا الملف، لكن معظمها مواقع مهتمة بـ SEO.
يمكن لكل من Yoast SEO وAIOSEO وWix وMintlify وGitBook إنشاء الملف لك، كما أضاف Lighthouse في Chrome فحصًا لملف llms.txt ضمن فئته الجديدة "Agentic Browsing" في مايو 2026. ولا ينبّه هذا الفحص إلا إلى الملف الذي يُرجع خطأ؛ أما غياب الملف فيُحتسب "غير منطبق". وتنشر شركات الذكاء الاصطناعي نفسها ملفات llms.txt أيضًا، لكن لوثائق المطورين لديها فقط.
هل تقرؤه محركات البحث بالذكاء الاصطناعي فعلًا؟
هنا تنهار الضجة المثارة حوله.
Google: "بحث Google يتجاهلها"
يدرج دليل Google لعام 2026 حول التحسين لميزات الذكاء الاصطناعي التوليدي لديها ملف llms.txt ضمن الأمور التي يمكنك تجاهلها. ويقول إنك لا تحتاج إلى ملفات جديدة قابلة للقراءة آليًا، أو ملفات نصية للذكاء الاصطناعي، أو Markdown لكي تظهر في بحث Google أو ميزات الذكاء الاصطناعي فيه، "لأن بحث Google نفسه لا يستخدمها". ويضيف تحديث صادر في يونيو 2026 أن إنشاء هذا الملف لخدمات أخرى لا بأس به، لكنه "لن يضر ولن يفيد" ظهورك في بحث Google. بل إن John Mueller من Google شبّهه بوسم keywords الوصفي القديم.
OpenAI وAnthropic وPerplexity: صمت تام
لا تذكر أيٌّ من وثائق الزواحف الصادرة عن OpenAI أو Anthropic أو Perplexity ملف llms.txt. لم تستبعده هذه الشركات، لكن لم تلتزم أي منصة ذكاء اصطناعي كبرى بقراءته.
السجلات: 97% من الملفات لم تتلقَّ أي طلب
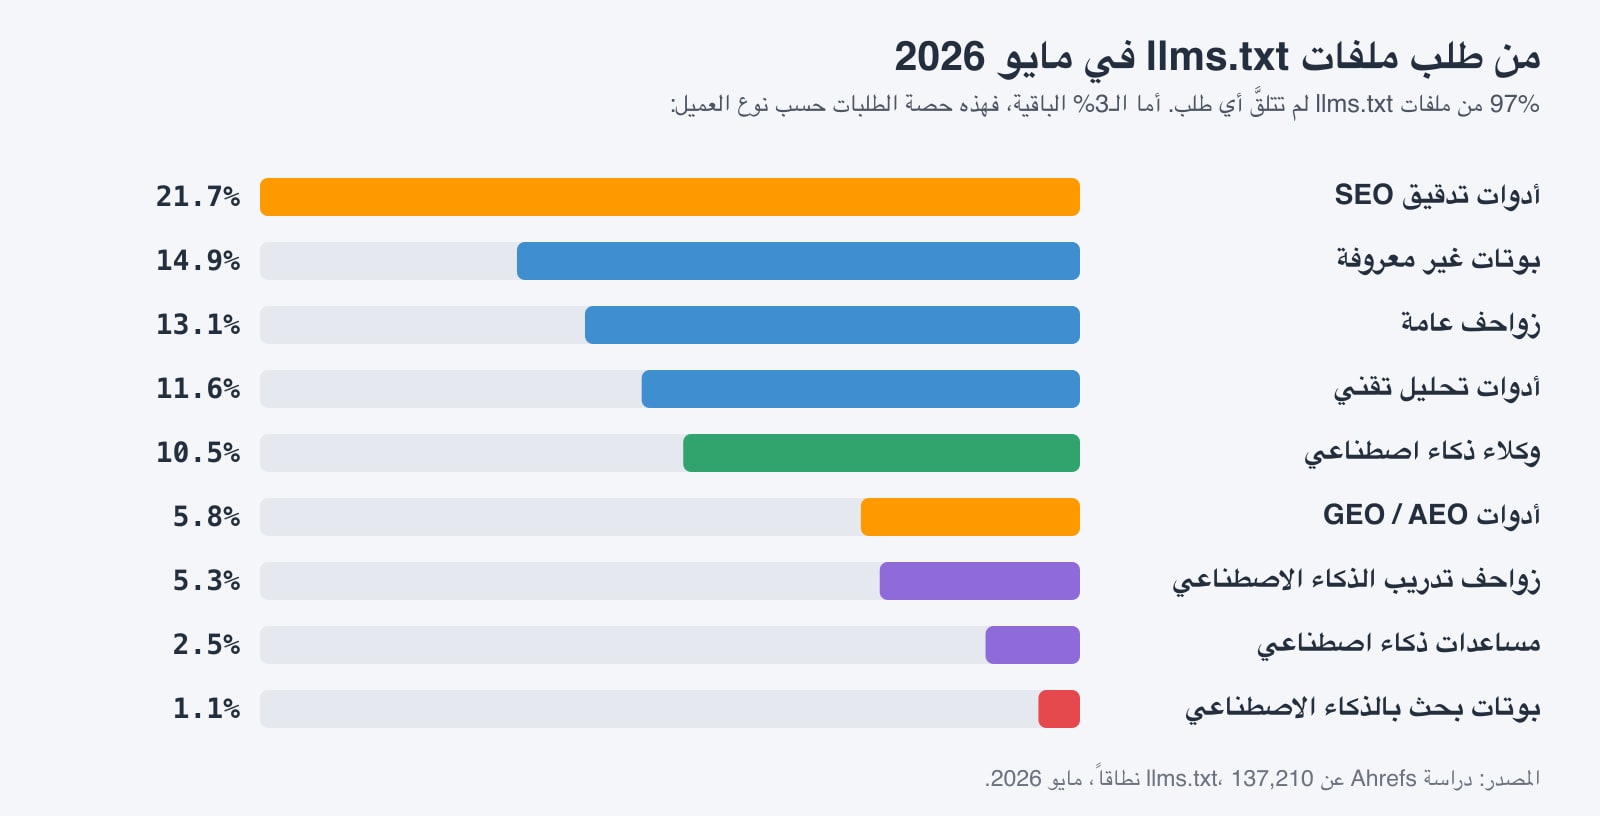
يأتي الدليل الأوضح من Ahrefs، التي حلّلت طلبات llms.txt عبر 137,210 نطاقات في مايو 2026. وكانت النتيجة: 97% من ملفات llms.txt لم تتلقَّ أي زيارة في ذلك الشهر، ولم يجلبها أي شيء على الإطلاق.
ومن بين الـ 3% التي جُلبت، جاءت معظم الطلبات من أدوات تدقيق SEO والزواحف العامة وأدوات تحليل المواقع. أما روبوتات البحث والاسترجاع بالذكاء الاصطناعي مثل OAI-SearchBot وPerplexityBot فلم تشكّل سوى 1.1% من الطلبات، أي بضع مئات من عمليات الجلب إجمالًا. كما أن روبوتات الذكاء الاصطناعي لم تطلب llms.txt قط من المواقع التي لا تملكه: فهي لا تبحث عنه أصلًا.
افحص سجلاتك بنفسك
لست مضطرًا إلى الاعتماد على كلام أحد. إذا كان موقعك يحتوي على ملف llms.txt، فسيُظهر لك هذا الأمر من طلبه:
# Who fetched llms.txt, by user agent (nginx/Apache combined log format)
grep -h '"GET /llms' /var/log/nginx/access.log* 2>/dev/null \
  | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -20

# cPanel: per-domain logs live under ~/access-logs/
zgrep -h '"GET /llms' ~/access-logs/* | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn
أين يفيد llms.txt فعلًا: مساعدو البرمجة بالذكاء الاصطناعي
هناك فئة واحدة من الأدوات تستخدمه: مساعدو البرمجة بالذكاء الاصطناعي مثل Claude Code وCursor، والأدوات المبنية عليهم. ففي بيانات Ahrefs، شكّل وكلاء الذكاء الاصطناعي 10.5% من طلبات llms.txt، وهي نسبة تفوق بكثير مجموع روبوتات البحث والمساعدين بالذكاء الاصطناعي معًا (3.6%)، وكان Claude Code أنشط أداة ذكاء اصطناعي مسمّاة بعد زاحف التدريب التابع لـ OpenAI. وعندما يوجّه مطوّر إحدى هذه الأدوات إلى وثائقك، يتيح لها فهرس نظيف لصفحات Markdown العثور على مرجع API المناسب بسرعة، مع استهلاك عدد أقل بكثير من الرموز (tokens): فقد قاست Cloudflare صفحة واحدة فبلغت 16,180 رمزًا بتنسيق HTML و3,150 رمزًا بتنسيق Markdown، أي أقل بنحو 80%.
إذن القاعدة العامة بسيطة:
- إذا كنت تنشر وثائق للمطورين أو API أو منتجًا برمجيًا: أضف ملف llms.txt ونسخًا بتنسيق Markdown من صفحات وثائقك. إنها مهمة صغيرة، وتسهّل الأمور على المطورين الذين يستخدمون أدوات الذكاء الاصطناعي.
- إذا كنت تدير موقعًا تجاريًا أو متجرًا أو مدونة: الملف لا يضر، وإذا كانت إضافة SEO لديك تنشئه تلقائيًا فاتركه مفعّلًا. لكن لا تتوقع أي تغيير في زيارات البحث بالذكاء الاصطناعي.
ما الذي يُدخلك فعلًا في البحث بالذكاء الاصطناعي
وفقًا لـ Google، كي تظهر الصفحة كرابط في AI Overviews أو AI Mode، يكفي أن تكون مفهرسة ومؤهلة لعرض مقتطف في البحث العادي. "لا توجد متطلبات تقنية إضافية". فما يهم هو نفسه ما يهم في SEO الجيد، مع بعض التفاصيل الخاصة بالذكاء الاصطناعي.
1. لا تحظر زواحف الذكاء الاصطناعي التي تريدها
تشغّل كل شركة ذكاء اصطناعي عدة روبوتات، ولكل منها مهمة مختلفة. حظر روبوت التدريب لا يُخرجك من البحث بالذكاء الاصطناعي، أما حظر روبوت البحث فيُخرجك منه:
- OAI-SearchBot يحدد ما إذا كنت ستظهر في بحث ChatGPT، أما GPTBot فمخصص للتدريب.
- Claude-SearchBot يفهرس لبحث Claude؛ وClaudeBot مخصص للتدريب؛ وClaude-User يجلب الصفحات عندما يطلبها المستخدم.
- PerplexityBot يشغّل بحث Perplexity ولا يُستخدم للتدريب.
- Google-Extended ليس زاحفًا، بل مفتاح في robots.txt خاص بتدريب Gemini وتأسيس إجاباته (grounding)، ولا يؤثر في بحث Google أو AI Overviews. وللحد من ظهورك في AI Overviews، استخدم
nosnippetأوmax-snippet. - Applebot-Extended يتحكم فقط في ما إذا كان بإمكان Apple استخدام المحتوى للتدريب.
إليك ملف robots.txt يُبقيك ظاهرًا في البحث بالذكاء الاصطناعي مع إلغاء الاشتراك في تدريب النماذج:
# Allow AI search and user-requested fetches
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Allow: /

# Opt out of model training
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
افحص جدار الحماية وشبكة CDN أيضًا تشير Google إلى أن الزحف يجب أن يكون مسموحًا به في robots.txt وكذلك من قِبل أي CDN أو بنية تحتية للاستضافة. فقد تحظر قواعد الحماية من الروبوتات في CDN أو إضافة أمان زواحفَ البحث بالذكاء الاصطناعي بصمت حتى لو سمح بها robots.txt، لذا افحص هذه الإعدادات أيضًا.
يمكنك أيضًا التعبير عن تفضيلاتك بدقة أكبر عبر Content Signals من Cloudflare، التي تضيف سطرًا مثل Content-Signal: search=yes, ai-input=yes, ai-train=no إلى robots.txt. وتعمل IETF على وضع مفردات قياسية لتفضيلات استخدام الذكاء الاصطناعي، لكنها لا تزال مسودة.
2. ضع محتواك في HTML
معظم زواحف الذكاء الاصطناعي لا تشغّل JavaScript. فقد وجدت دراسة أجرتها Vercel في 2024 أن أيًّا من زواحف الذكاء الاصطناعي الكبرى التي قاستها لم يعرض JavaScript، باستثناء زاحفَي Google وApple. فإذا كانت نصوصك أو أسعارك أو تفاصيل منتجاتك لا تظهر إلا بعد تشغيل السكربتات، فقد ترى أدوات الذكاء الاصطناعي صفحة فارغة. استخدم العرض من جانب الخادم، أو نظام إدارة محتوى مثل WordPress يُخرج المحتوى بتنسيق HTML. وتحقّق مما يراه الزاحف:
# Fetch the raw HTML the way a crawler does, then look for your key text
curl -s -A "OAI-SearchBot/1.0" https://example.com/pricing | grep -i "per month"
3. حافظ على قوة الأساسيات
- صفحات واضحة ومحددة تجيب عن أسئلة حقيقية، مع عناوين وقوائم.
- بيانات منظَّمة تطابق ما يظهر في الصفحة. وهي ليست مطلوبة للبحث بالذكاء الاصطناعي، لكنها تساعد في الحصول على نتائج غنية.
- خريطة موقع، وروابط داخلية جيدة، وموقع سريع وموثوق. وتتضمن إرشادات Google تقليل زمن الاستجابة كجزء من تجربة الصفحة الجيدة.
- خبرة حقيقية وسمعة تدفع المواقع الأخرى إلى الاستشهاد بك.
كيف نتعامل مع الأمر في WebGee
ننشر ملف llms.txt على webgee.com، لأن صيانته قليلة التكلفة ويساعد أدوات الذكاء الاصطناعي التي تقرؤه فعلًا. كما يعبّر ملف robots.txt لدينا عن تفضيلاتنا تجاه الذكاء الاصطناعي عبر Content Signals. لكن العمل الذي يهم حقًا هو الجزء الممل: صفحات تُعرض من جانب الخادم، واستضافة سريعة، وبيانات منظَّمة نظيفة، ومحتوى يكتبه أشخاص يديرون الاستضافة كل يوم.
وهذا أيضًا ما صُمّمت استضافتنا من أجله. فخوادم الويب LiteSpeed مع التخزين المؤقت تُبقي الصفحات سريعة للزوار والزواحف على حد سواء، ولديك تحكم كامل في إعدادات robots.txt وCDN والأمان، مع دعم على مدار الساعة طوال أيام الأسبوع إذا احتجت إلى مساعدة في قراءة سجلاتك.
الأسئلة الشائعة
هل يحسّن llms.txt ترتيبي في Google أو في AI Overviews؟
لا. تؤكد Google أن بحث Google، بما في ذلك ميزات الذكاء الاصطناعي فيه، يتجاهل llms.txt، وأن وجوده لن يفيد ظهورك ولن يضرّه.
هل يقرأ ChatGPT ملف llms.txt؟
لم تعلن OpenAI قط أنها تستخدم llms.txt، وتُظهر بيانات السجلات في 2026 أن زاحف البحث التابع لها لا يكاد يطلبه أبدًا. يعتمد بحث ChatGPT على OAI-SearchBot، ويجب أن تسمح له في robots.txt حتى تظهر فيه.
هل llms.txt ضار؟
لا. نشره لا يسبب أي ضرر، وهو مفيد إذا كانت لديك وثائق للمطورين. لكن لا تتوقع أن يجلب لك زيارات من البحث بالذكاء الاصطناعي.
ما هو llms-full.txt؟
ملف واحد يضم جميع وثائق الموقع بتنسيق Markdown. وهو عُرف أطلقته منصات التوثيق مثل Mintlify، وليس جزءًا من مواصفات llms.txt.
كيف أمنع نماذج الذكاء الاصطناعي من التدرّب على محتواي مع البقاء في البحث بالذكاء الاصطناعي؟
في robots.txt، امنع روبوتات التدريب مثل GPTBot وClaudeBot وGoogle-Extended وApplebot-Extended، واسمح لروبوتات البحث مثل OAI-SearchBot وClaude-SearchBot وPerplexityBot.